
 ChatGPT
 Perplexity
 Gemini
 Claude
 Grok
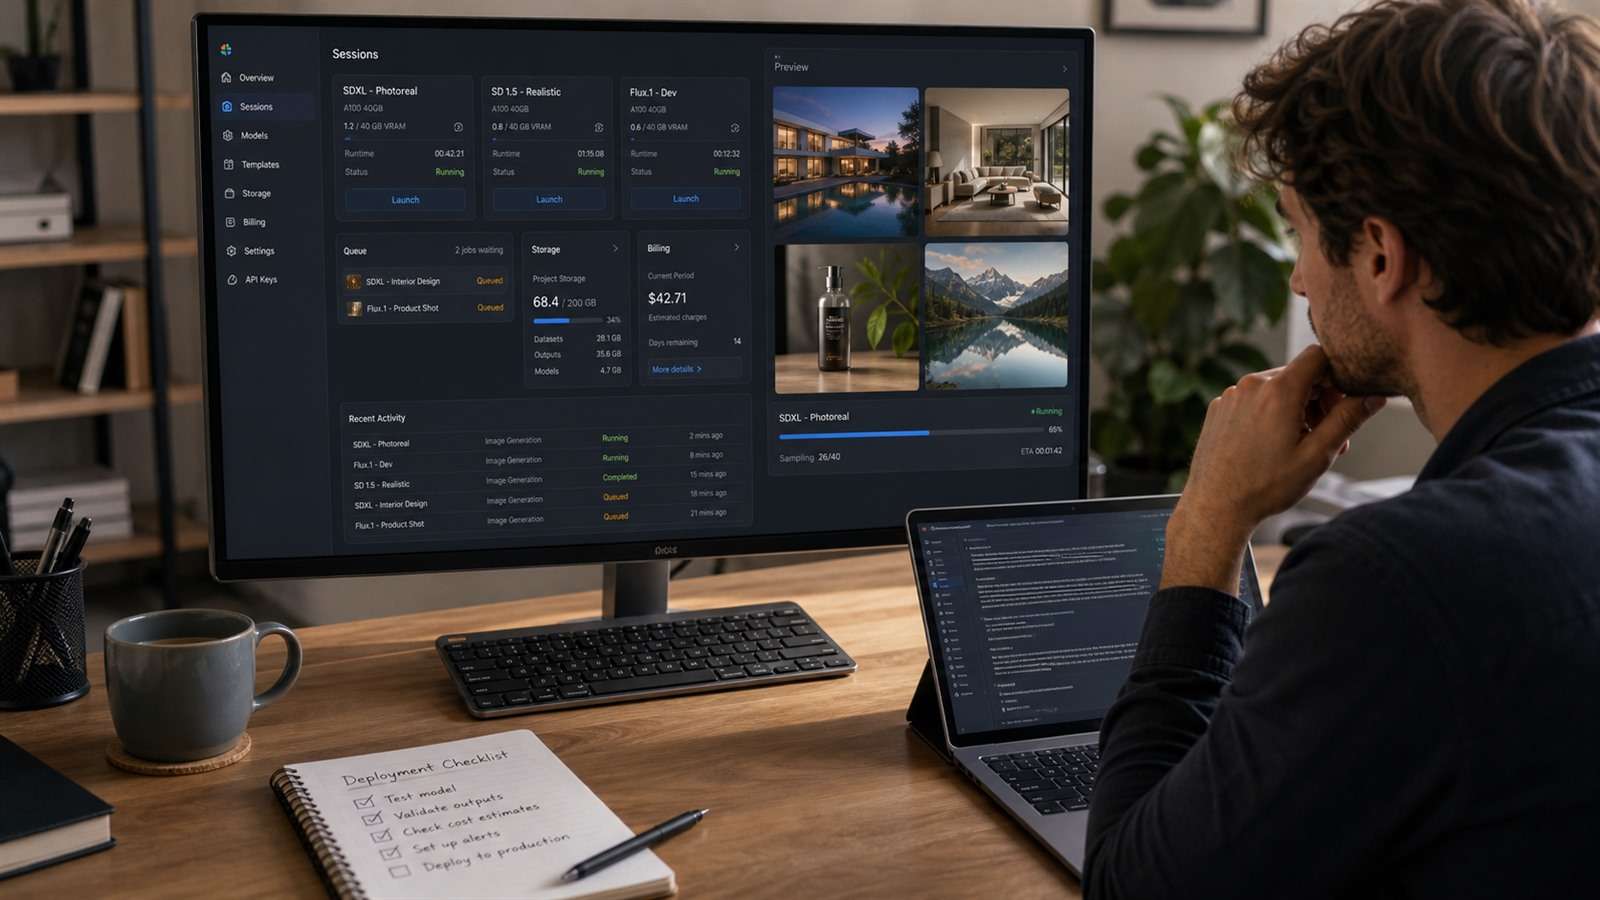
RunDiffusion ha inizialmente attratto i creator che desideravano Automatic1111, ComfyUI, Fooocus, modelli e potenza GPU senza dover costruire una workstation. La sua piattaforma attuale comprende anche strumenti multimodello per immagini e video, bacheche, team, governance e plugin. Questa ampiezza significa che un'alternativa a RunDiffusion può essere sia uno studio creativo gestito che un'infrastruttura grezza in affitto—e la fattura si comporta in modo molto diverso.
In questo articolo
Il Contatore Gira Mentre Scarichi Modelli, Esegui il Debug dei Nodi e Dimentichi di Fermarti
Il prezzo orario della GPU è solo una componente del costo. Una stima mensile realistica è:
Tempo di sessione GPU + archiviazione persistente + trasferimento di rete + abbonamento alla piattaforma + tempo perso per configurazioni fallite + manutenzione umana
Un'istanza da $0,50 all'ora può essere costosa se impiega 25 minuti a ricostruire un ambiente. Una macchina gestita da $1,50 può essere economica se modelli, estensioni e output persistono e il creator inizia a generare immediatamente. L'arresto automatico, il rilevamento dell'inattività, il tempo di avvio e l'accesso ai file quando la GPU è spenta meritano le proprie righe nel confronto.
Aggiungi alla stima il lavoro e il recupero dai guasti. Un'istanza grezza può essere più economica per GPU-ora ma più costosa per un designer che spende tempo fatturabile a ricostruire container, riparare percorsi di modelli o spiegare una configurazione non documentata a un collega. Un servizio gestito guadagna il suo premio solo quando il tempo risparmiato è misurabile.
Scegli uno Studio Gestito o un'Infrastruttura—Non Fingere che Siano la Stessa Cosa
| Percorso | Esempi | Ideale per | Onere operativo |
|---|---|---|---|
| Studio di diffusione gestito | ThinkDiffusion | Artisti che desiderano interfacce precaricate e file creativi persistenti | Da basso a medio |
| Piattaforma GPU a container | RunPod | Utenti tecnici che distribuiscono template, pod e API | Medio |
| Marketplace GPU | Vast.ai | Utenti attenti ai costi in grado di valutare host e istanze | Alto |
| Notebook/sviluppo cloud | Paperspace | Codice, addestramento, esperimenti e lavoro ML più ampio | Da medio ad alto |
| Flusso di lavoro a nodi ospitato | Comfy Cloud | Utenti ComfyUI che evitano l'installazione locale | Da basso a medio |
| Workstation locale | ComfyUI, Invoke, Forge | Uso intenso e ripetuto, privacy e proprietà del flusso di lavoro | Alto upfront; inferiore per sessione |
| Piattaforma creativa consumer | Media.io | Utenti che necessitano di output, non di infrastrutture di diffusione | Basso |
Sette Alternative a RunDiffusion
1. ThinkDiffusion — il laboratorio cloud gestito più simile
ThinkDiffusion offre macchine cloud dedicate con interfacce creative precaricate, unità private, upload di modelli, estensioni, nodi personalizzati e opzioni di archiviazione persistente. Il suo percorso Hobby pay-as-you-go e i livelli di abbonamento lo rendono paragonabile al tradizionale caso d'uso di RunDiffusion.
Confronta la VRAM della macchina, l'archiviazione di base, la finestra di persistenza, l'accesso ai file quando è ferma e le tariffe orarie scontate. La corrispondenza di funzionalità più vicina non è automaticamente la corrispondenza più economica per il tuo modello di utilizzo.
2. RunPod — template, pod e percorsi serverless per team tecnici
RunPod è più simile a un'infrastruttura. Si adatta agli utenti che possono distribuire un template, collegare un'archiviazione, gestire porte e container e decidere se un pod interattivo o un carico di lavoro in stile API sia appropriato. Può essere flessibile ed economicamente efficiente, ma la risoluzione dei problemi spetta a te.
3. Vast.ai — prezzi da marketplace per utenti in grado di valutare il rischio
Vast.ai espone un marketplace di host GPU con hardware, affidabilità, larghezza di banda, archiviazione e prezzi variabili. È interessante per utenti esperti che ottimizzano i costi. È una scelta inadatta per chi desidera un unico team di supporto e un'esperienza macchina uniforme.
Filtra oltre il nome della GPU. La larghezza di banda PCIe, la velocità del disco, il trasferimento internet, la verifica, il punteggio di affidabilità e l'interrompibilità possono influenzare un carico di lavoro di diffusione.
4. Paperspace — notebook e lavoro di machine learning più ampio
Paperspace si adatta a progetti che mescolano la generazione di immagini con notebook, codice, dataset ed esperimenti con modelli. È meno uno studio artistico chiavi in mano e più un ambiente di sviluppo. Sceglilo se Stable Diffusion è uno dei carichi di lavoro all'interno di un progetto ML più grande.
5. Comfy Cloud — rimani in ComfyUI senza mantenere un'installazione locale
Comfy Cloud è l'alternativa naturale quando il tuo asset importante è il grafico ComfyUI, non un desktop ospitato specifico. Riduce l'attrito dell'installazione locale preservando il modello mentale basato su nodi. Verifica la disponibilità di nodi personalizzati, l'accesso ai modelli, la conservazione e i prezzi rispetto ai flussi di lavoro che utilizzi effettivamente.
6. Una workstation locale ComfyUI o Invoke — proprietà prevedibile per un uso intenso
L'hardware locale trasforma la spesa cloud variabile in un acquisto iniziale più costi di energia, archiviazione e manutenzione. È interessante per lavori frequenti con grandi dataset privati, caricamenti ripetuti di modelli o dipendenze personalizzate. È meno attraente se generi occasionalmente o hai bisogno di più VRAM di quanta puoi giustificare l'acquisto.
7. Media.io — evita del tutto la decisione sull'infrastruttura
Se non hai bisogno di checkpoint, nodi personalizzati o un desktop remoto, una piattaforma per creator potrebbe risolvere il lavoro concreto con una configurazione molto più ridotta. Media.io Text to Image gestisce la creazione di immagini basata su browser, e Image to Image supporta trasformazioni di riferimento e modifiche successive.
Questa non è una sostituzione equivalente di una GPU cloud. È la risposta migliore quando il requisito è "produrre immagini per campagne e continuare a modificarle" piuttosto che "ospitare il mio stack di diffusione personale."
Esegui un Benchmark di Archiviazione e Avvio Prima di Spostare i Tuoi Modelli
- Crea un account o uno spazio di lavoro pulito e avvia una GPU di destinazione.
- Misura il tempo fino a quando l'interfaccia è utilizzabile.
- Installa un nodo personalizzato non predefinito e un modello rappresentativo.
- Esegui un flusso di lavoro fisso e registra il tempo di generazione e il picco di VRAM.
- Ferma la macchina; verifica quale archiviazione continua a essere fatturata.
- Riavvia dopo un giorno e dopo la finestra di persistenza gratuita.
- Scarica i risultati senza accendere una GPU costosa, se supportato.
- Attiva l'arresto automatico e verifica che si comporti come previsto.
Testa anche il recupero da un nodo rotto o da un percorso di modello errato. La migrazione non ha successo finché un altro membro del team non riesce a rilanciare il flusso di lavoro seguendo le istruzioni scritte.
Ripeti il benchmark dopo che lo spazio di lavoro è stato fermato per un giorno intero. Registra cosa sopravvive: checkpoint, LoRA, nodi personalizzati, variabili d'ambiente, output e JSON del flusso di lavoro. Alcuni servizi preservano un volume indipendentemente dalla GPU; altri addebitano continuamente o trattano la macchina come usa e getta. Il comportamento di recupero è parte del prodotto.
Quando Acquistare una GPU Diventa Razionale
Calcola il punto di pareggio dividendo il costo totale della workstation per la spesa cloud mensile evitata, quindi aggiungi l'elettricità e il valore del tuo tempo di manutenzione. Il locale vince prima quando generi quotidianamente, conservi centinaia di gigabyte di modelli o sposti grandi dataset privati. Il cloud vince quando l'utilizzo è a picchi, sono necessarie diverse dimensioni di GPU o il team non può manutenere driver e ambienti.
FAQ sulla Diffusione Cloud
-
Qual è l'alternativa più vicina a RunDiffusion?
ThinkDiffusion è la corrispondenza più vicina per uno spazio di lavoro cloud gestito con le più popolari interfacce Stable Diffusion, archiviazione privata, modelli ed estensioni. Confronta le tariffe attuali delle macchine e le regole di persistenza. -
RunPod è più economico di RunDiffusion?
Può avere prezzi di calcolo grezzo inferiori, ma il costo totale dipende dal tempo di configurazione, dall'archiviazione, dal trasferimento, dalle sessioni inattive e dalla manutenzione. Confronta il costo per flusso di lavoro completato, non solo la tariffa GPU elencata. -
Posso spostare un flusso di lavoro ComfyUI tra servizi?
Di solito sì, ma il flusso di lavoro potrebbe dipendere da nodi personalizzati, percorsi di modelli, versioni e API proprietarie. Esporta il JSON e registra ogni dipendenza. -
Cosa succede ai modelli quando una sessione cloud si interrompe?
Dipende dall'archiviazione collegata e dal piano. Alcuni servizi mantengono un'unità, altri addebitano separatamente e altri eliminano i file dopo una finestra di inattività. Verifica prima di caricare una grande libreria di modelli. -
Dovrei usare hardware locale invece?
L'hardware locale è adatto a carichi di lavoro frequenti, privati e stabili. I servizi cloud sono adatti a picchi occasionali, esigenze di GPU variabili e utenti che non desiderano un acquisto hardware iniziale.