シーンが変わるたびにナレーターがわずかに変化すると、観客はその理由を説明できなくても気づいてしまいます。声の一貫性は音色だけの問題ではありません。ペース、アクセント、息づかい、感情、発音、音量、そして部屋の響きのすべてが、同じ合成音声を別人のように感じさせる可能性があります。
Curious Refugeは、専用の音声一貫性チュートリアルでこれら3つのワークフローを比較しています。まずコントラストを確認し、次にこのガイドの残りの部分を使用して、好みの音声を、制御されたスクリプト、設定、多言語デリバリー、正規化、およびQAを備えた繰り返し可能なシリーズ仕様に変換してください。
この記事の内容
プロジェクトにおける「同じ声」の意味を定義する
音声のアイデンティティは一貫性の一部に過ぎません。2つのクリップが同じ合成音声を使用していても、異なるプロダクションのように聞こえることがあります。
複数の次元でターゲットを定義してください:
| 一貫性の次元 | 固定すべき項目 |
| 声のアイデンティティ | 音色、アクセント、見かけの年齢、コアキャラクター。 |
| デリバリー | 落ち着いた、エネルギッシュ、会話的、権威的、またはユーモラス。 |
| ペース | おおよその1分あたりの語数とポーズスタイル。 |
| 感情 | ニュートラルなベースラインと許容される感情の範囲。 |
| 録音の特性 | ドライスタジオ、温かみのあるブース、近接マイク、またはその他の一貫したサウンド。 |
| 音量 | 最終エクスポートのターゲットレベル。 |
| 発音 | 名前、頭字語、製品名、地名、および専門用語。 |
これらを音声仕様書に記載してください。有用な仕様書の例:「温かみのある女性ナレーター、明瞭なニュートラルなアメリカ英語、中程度のペース、自信があるが押しつけがましくない、文と文の間の短いポーズ、過剰な息づかいなし、ドライスタジオサウンド、一貫した製品名の発音。」
音声仕様書は、すべてのスクリプトとQAパスのリファレンスとなります。
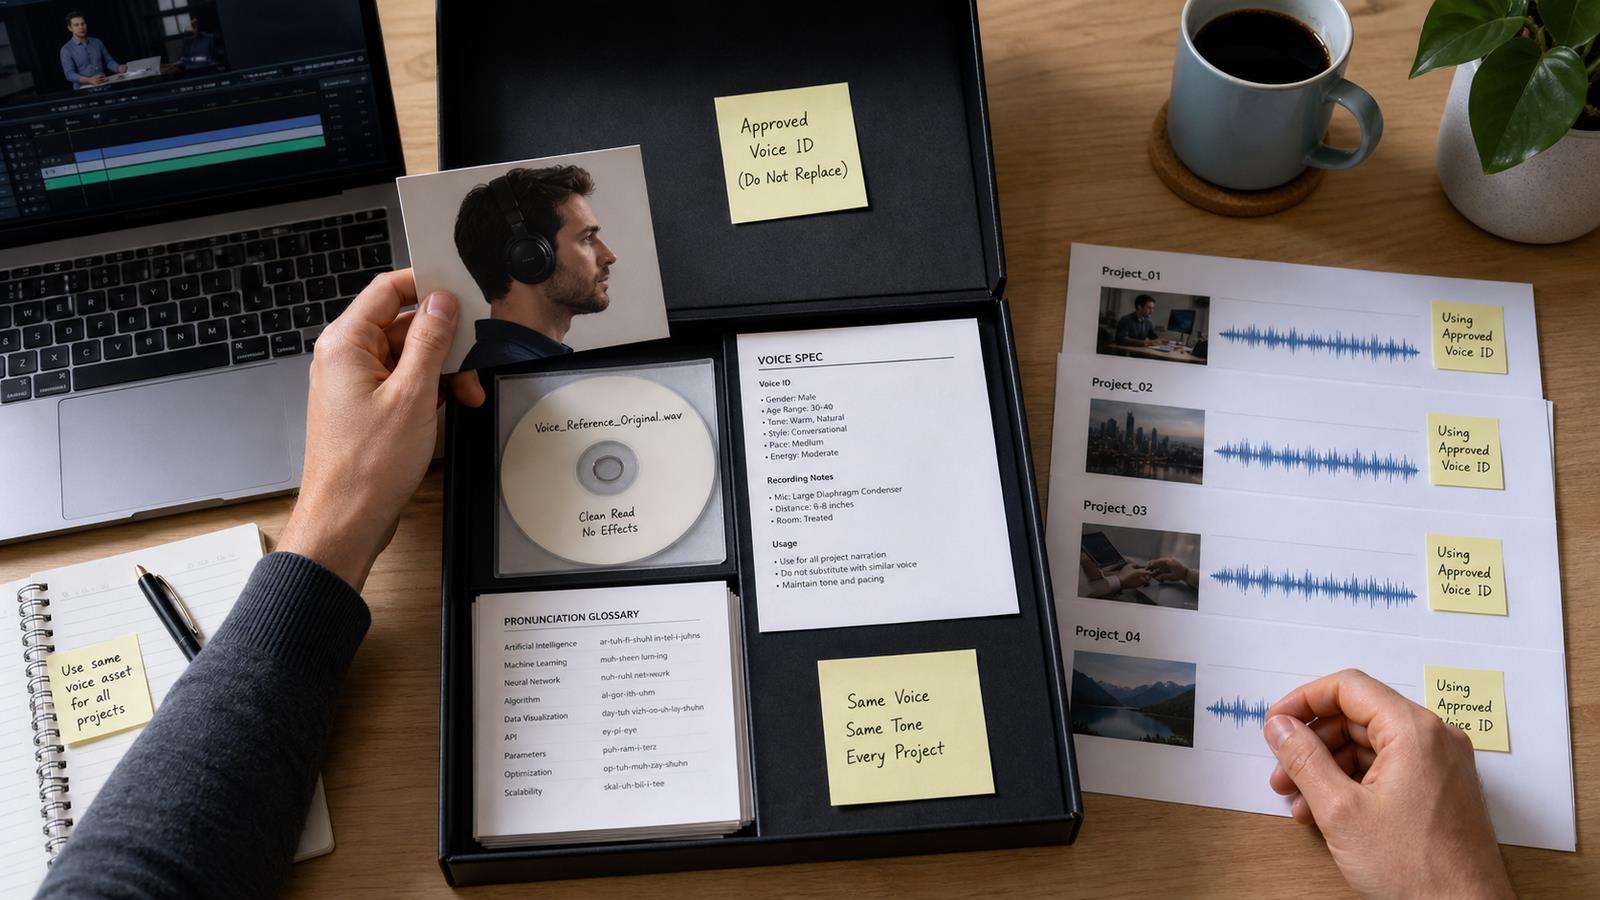
似たような声ではなく、同じ音声アセットを使用する
プラットフォームが音声ID、保存された音声、またはクローン音声を提供している場合は、シリーズ全体で全く同じアセットを再利用してください。プレビューが近いからといって新しい音声を選ばないでください。
クローン音声の場合は、元のソース録音を保管しておいてください。ElevenLabsは、同じサンプルからクローンを再作成しても、わずかに異なるクローンが生成される可能性があると指摘しています。これが、後で再構築するのではなく、承認済みの音声アセットを保存しておくべきもう一つの理由です。
Media.ioのAIボイスクローニングワークフローを使用して、ナレーション、マーケティング、教育、または動画のボイスオーバー用に再利用可能な音声を作成できます。一貫性が重要な場合は、承認済みのクローンを名前付きのプロダクションアセットとして扱い、どのプロジェクトがそれを使用しているかを記録してください。
クリーンで一貫したリファレンスオーディオから始める
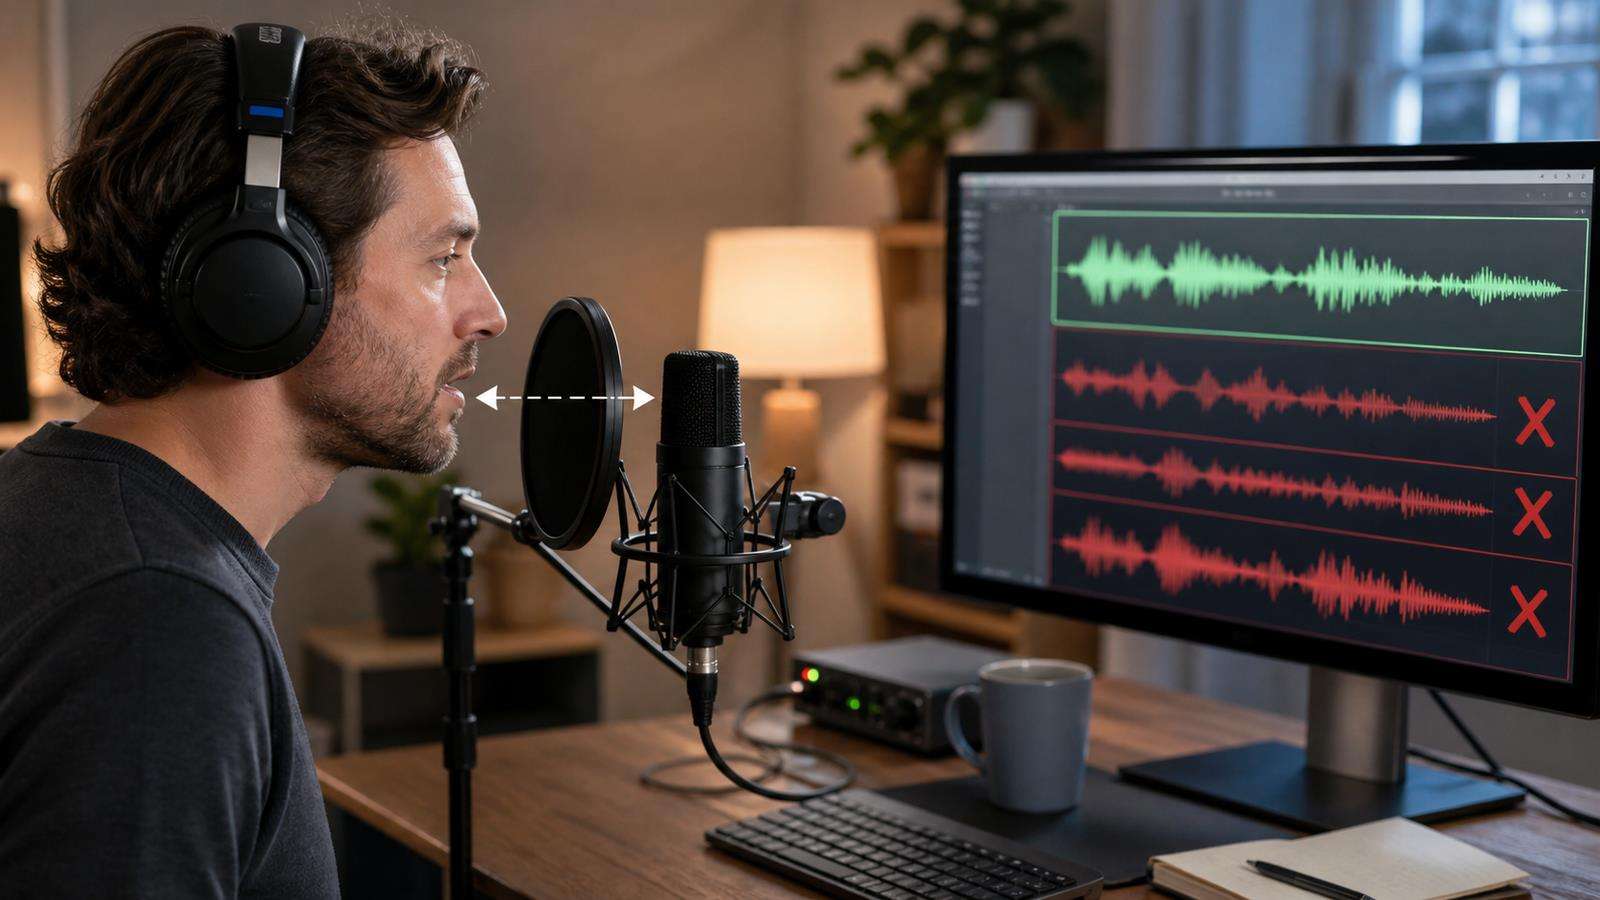
クローンは聞いた内容から学習します。背景ノイズ、部屋の残響、マイクの変更、大きな音量の変動、そして混在したパフォーマンススタイルは、生成される音声の予測可能性を低下させる可能性があります。
ElevenLabsは、一貫した音量、トーン、音質、パフォーマンスを持つクリーンな単一話者の録音を推奨しています。インスタントボイスクローニングワークフローでは、約1〜2分の良質なオーディオを推奨しています。プロフェッショナルなクローニングにははるかに多くの素材が必要ですが、重要な原則は同じです:質と一貫性はランダムな録音時間を集めることよりも重要です。
実際に再現したい音声を録音してください。ターゲットが落ち着いたコーポレートナレーターであれば、ささやき声、叫び声、キャラクター演技、カジュアルな電話録音を同じリファレンスセットに混在させないでください。複数の感情モードが必要な場合は、トレーニングデータが偶然の混合物になるのを防ぐため、意図的に管理してください。
シリーズ全体で音声設定を固定する
多くのTTSシステムは一貫性に影響するコントロールを提供しています。名称はプラットフォームによって異なりますが、一般的なコントロールには安定性、類似性、スタイル、速度、ピッチ、感情、言語などがあります。
承認済みクリップに使用した設定を記録してください。動画ごとに安定性やスタイルを変更すると、意図的に音声の動作を変えていることになります。
ElevenLabsは、安定性を出力がリファレンスにどれだけ忠実であるか、および生成間にどれだけのランダム性が現れるかを制御するものとして説明しています。また、スタイルの誇張が強すぎると安定性が低下する可能性があると警告しています。これは有用な一般的な教訓です:表現力のために設計された設定は、シリーズの均一性を低下させる可能性があります。
プロダクションでは、1つのベースラインプリセットを確立してください。コンテンツが本当に必要とする場合にのみ、別の名前付きプリセットを作成してください。例えば、Narrator_Neutral, Narrator_Excited、およびNarrator_Softなどです。すべてのクリップで感覚的にスライダーを調整しないでください。
Media.ioのテキスト読み上げでは、音声、言語、速度、ピッチの選択も可能です。一連の動画が1つのナレーションスタイルを共有する必要がある場合は、それらの選択を記録しておいてください。
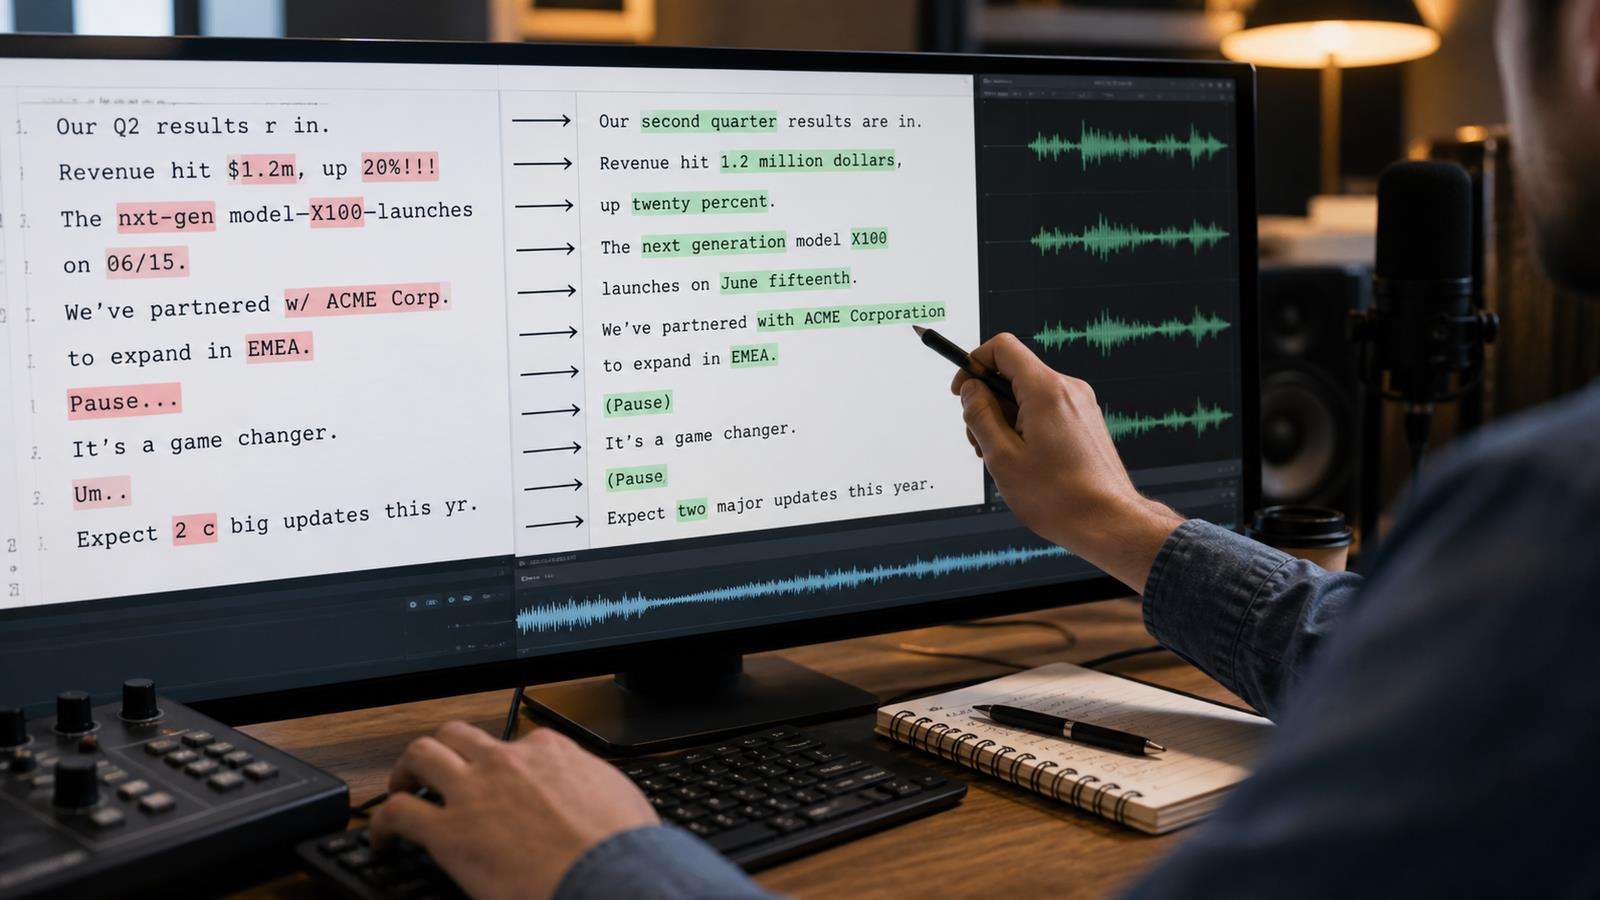
オーディオを生成する前にスクリプトを標準化する
音声のバリエーションは、音声モデルだけでなく、テキストのフォーマットからも生じる可能性があります。
以下のスクリプトルールを作成してください:
- 文の長さ。
- 句読点のスタイル。
- 数字と日付。
- 頭字語。
- 製品名。
- URL。
- ポーズ。
- 強調。
- 外来語。
あるスクリプトが「2026」と書き、別のスクリプトが「twenty twenty-six」と書いた場合、発音が異なる可能性があります。一方が「AI」を使用し、もう一方が「A.I.」を使用した場合、リズムが変わることがあります。同じ製品名がハイフンありとハイフンなしで表記された場合、モデルの発音が異なる可能性があります。
発音用語集を作成してください。システムがサポートしている場合は、難しい用語を音声的にスペルアウトするか、すでにテスト済みの安定したテキスト形式を使用してください。
管理しやすいセグメントで生成する
長い生成はエネルギー、音量、ペース、発音においてドリフトする可能性があります。スクリプトをより小さな論理的なセグメントに分割することで、弱いラインのみを再生成し、リファレンスと比較しやすくなります。
ElevenLabsのトラブルシューティングガイダンスでは、長い生成で音量や品質が変化する場合に、テキストをより小さなセグメントに分割することを具体的に提案しています。セグメントは、ツールとコンテンツに応じて、1段落、1シーン、または10〜30秒のナレーションになることがあります。
パフォーマンスが細切れになりすぎない限り、すべての文を別々のファイルにしないでください。プロソディが自然に流れるように、一つの考えに属する文をグループ化してください。タイミングのために、始まりと終わりに編集ハンドルを残してください。
ファイルには体系的な名前を付けてください。例えば:
EP04_S03_VO_01.wav
EP04_S03_VO_02.wav
これにより、ラインをスクリプトに追跡し、必要なセグメントのみを再生成することが容易になります。
感情の範囲を意図的に保つ
一貫性はモノトーンのデリバリーを意味しません。ナレーターは、同じ声を保ちながら、明かしのシーンではより興奮し、説明のシーンではより落ち着いた様子で聞こえることができます。重要なのは範囲を定義することです。
シリーズのための小さな感情マップを作成してください:
- フック:エネルギッシュ、短いフレーズ。
- 説明:ニュートラルで明瞭。
- 警告:よりゆっくりでより真剣。
- CTA:温かみがあり、自信があり、叫んでいない。
クリップが突然、他のどこにも存在しない劇的なパフォーマンスを使用すると、別のナレーターのように聞こえます。感情スタイルをベースラインの音声に関連づけて保ってください。
システムが高度に表現豊かなコントロールを提供している場合は、複数の候補を生成し、承認済みリファレンスに最も近いものを選択してください。最もドラマチックなテイクが最良のテイクであると思い込まないでください。
言語をまたいで音声を慎重に合わせる
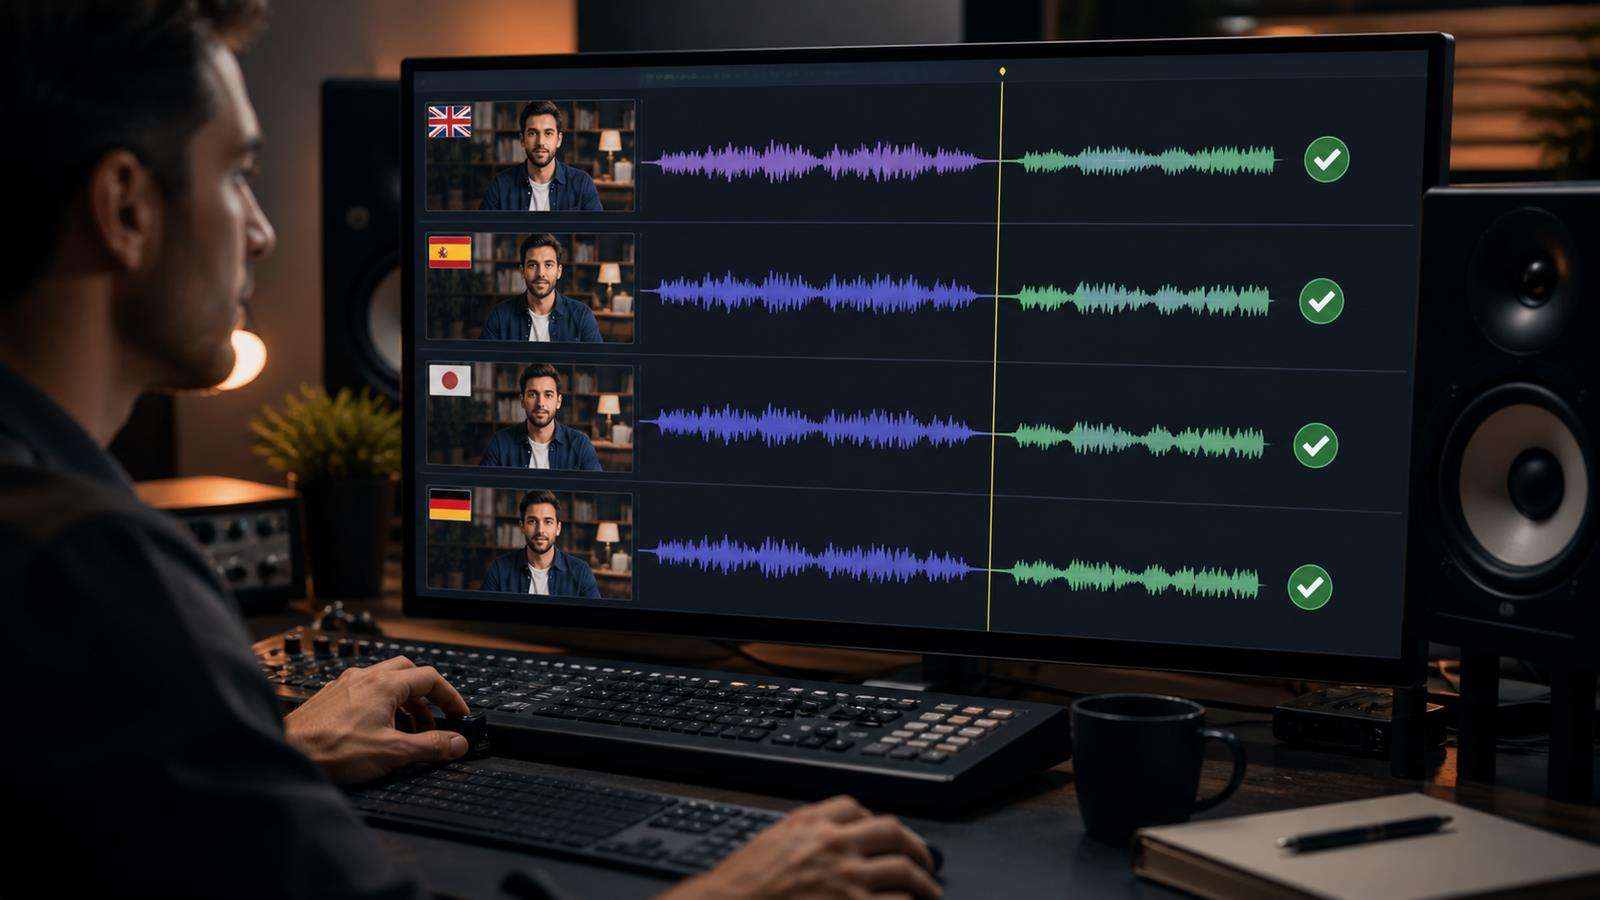
多言語プロダクションは別のレイヤーを導入します。スペイン語や日本語を話すクローン英語音声は、一部のアイデンティティを保持しながらも、アクセント、リズム、発音が変わる可能性があります。ElevenLabsは、クローン音声が別の言語で話す際に、ソース録音で使用された言語のアクセントを持ち込む可能性があると指摘しています。
市場をまたいで一貫性が何を意味するかを決定してください。1つのグローバルな音声アイデンティティを優先するか、異なるターゲット言語の音声を使用してネイティブのローカルデリバリーを優先するかを選択できます。どちらも有効なブランド戦略です。
既存のトーキング動画の場合、Media.ioのAIリップシンクを使用して、置き換えオーディオを映像内の話者に同期させることができます。静止した発表者の場合、AIトーキングアバターを使用して、画像とスクリプトまたはオーディオから音声を作成できます。
ジェネレーターの設定だけでなく、完成したオーディオを正規化する
2つのクリップが同じTTS設定を使用していても、編集後に知覚される音量が異なる場合があります。バックグラウンドミュージック、コンプレッション、ノイズリダクション、および動画エクスポート設定が最終的なサウンドに影響します。
シリーズ用のオーディオ仕上げプリセットを作成してください。最低限、以下を確認してください:
- ラウドネス。
- ピークレベル。
- ノイズフロア。
- イコライゼーション。
- コンプレッション。
- 必要に応じてディエッシング。
- ルームトーンまたはアンビエンス。
- ナレーション下の音楽レベル。
クリップに特定の理由がない限り、同じ仕上げチェーンを適用してください。一部のソース参照にノイズが含まれている場合は、クローン作成前にクリーンアップしてください。Media.ioのAIノイズリデューサーは、不要なバックグラウンドサウンドがソースまたは最終ボイストラックに含まれている場合のクリーンアップをサポートできます。
QA中に音声リファレンスクリップを使用する
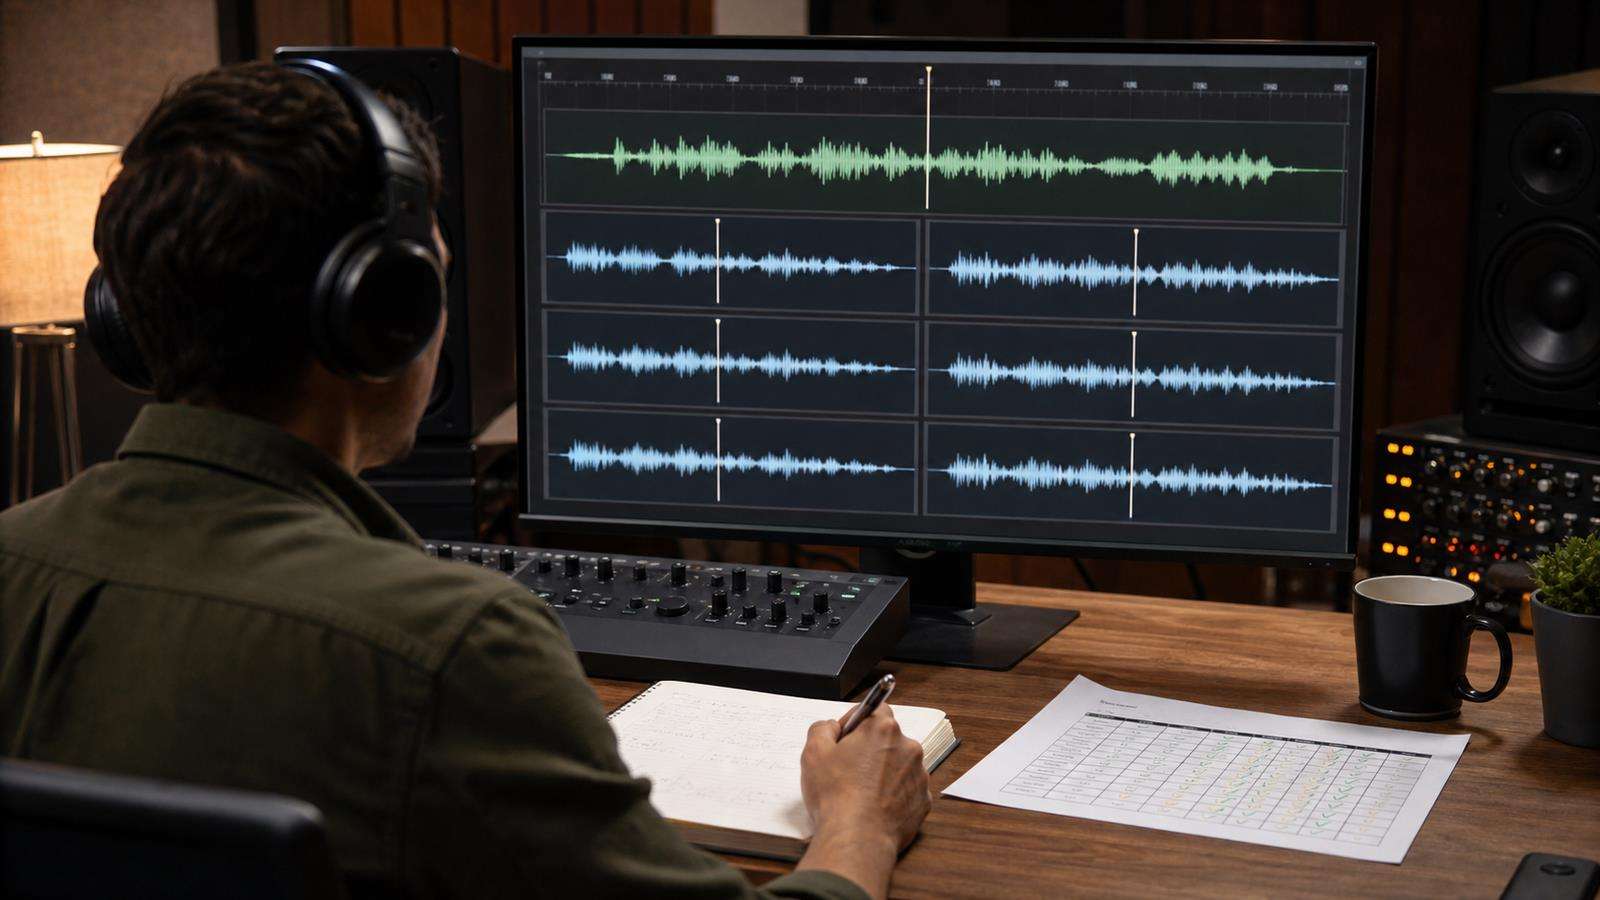
記憶に頼らないでください。すべてのレビューセッションの傍に、承認済みの短いボイスリファレンスを1つ用意してください。リファレンスを再生し、次に新しいクリップを再生してください。
比較する項目:
- アクセントと音色。
- ペース。
- 感情的なエネルギー。
- 発音。
- ブレシネス。
- ラウドネス。
- ルームまたは処理の特性。
並べて比較することで、わずかなずれをより聴き取りやすくなります。大規模なシリーズの場合は、各エピソードから1文のコンタクトリールを作成してください。サンプルを連続して聴くことで、個別の承認時には見えにくい徐々の変化を発見できます。
繰り返し可能なMedia.io音声ワークフローを構築する
安定したナレーターを得るには、一度ボイスを作成または選択し、設定とスクリプトの規則を一貫して保持してください。管理しやすいセクションでボイスオーバーを生成し、承認済みリファレンスと照合してレビューし、最終オーディオを動画ワークフローに配置してください。
再利用可能なクローンが必要な場合は、Media.io AIボイスクローニングから始めてください。スピードとピッチコントロールを備えた既成のボイスが必要な場合は、テキスト読み上げを使用してください。最終動画にすでに話す顔が含まれている場合は、ローカライズまたは修正されたオーディオが承認された後にリップシンクを使用してください。
AI音声一貫性チェックリスト
クリップのバッチを公開する前に、以下を確認してください:
- 同じ承認済みボイスまたはクローンが全体を通じて使用されている。
- リファレンスオーディオがクリーンで一貫している。
- ボイス設定が保存され、文書化されない限り変更されていない。
- スクリプトのフォーマットが1つの標準に従っている。
- 製品名と難しい用語が発音用語集に従っている。
- 長いスクリプトが管理しやすいセグメントに分割されている。
- 感情的な表現が承認された範囲内に収まっている。
- 最終オーディオが同じラウドネスと処理アプローチを使用している。
- すべての新しいクリップがリファレンスサンプルと比較されている。
- 多言語バージョンが意図的なアイデンティティ対ネイティブアクセント戦略に従っている。
一貫したAIボイスは、1つの完璧な設定によって作成されるものではありません。それは、入力、生成、スクリプト、パフォーマンス、およびポストプロセッシングを制御する再現可能なパイプラインの結果です。
モデルとワークフローのバージョンを管理下に置く
スクリプトと設定が同じままでも、基盤となる音声モデルが変更されると、ボイスがずれる可能性があります。制作ツールは時間の経過とともに改善され、新しいモデルは感情、ポーズ、発音、またはクローニングを異なる方法で処理する場合があります。プラットフォームがその情報を公開している場合は、承認済みシリーズに使用されたモデルまたはワークフローのバージョンを記録してください。
長期稼働チャンネルを新しいモデルに移行する前に、古い設定と新しい設定で短いベンチマークスクリプトを生成してください。シリーズに頻繁に登場する製品名、数字、感情的な範囲、および文のパターンを含めてください。パイプライン全体を切り替える前に、両方のバージョンを承認済みリファレンスボイスと比較してください。
新しいモデルの方が優れているが明らかに異なる場合は、その変更をリブランド決定として扱ってください。計画されたポイントからシリーズ全体を更新するか、クリーンな移行が可能になるまで既存のコンテンツに古いワークフローを維持してください。サイレントモデルの変更は、誰もボイスを意図的に変更していないにもかかわらず、ナレーターが時間とともに進化しているように見える理由の1つです。
AI音声一貫性に関するFAQ
同じAIボイスがクリップ間で異なる音に聞こえるのはなぜですか?
AI音声生成は完全に決定論的ではありません。リファレンスオーディオ、テキスト、句読点、設定、感情的な方向性、セグメントの長さ、およびポストプロセッシングの違いがすべて結果を変える可能性があります。
クローンしたボイスを一貫して保つにはどうすればよいですか?
クリーンなシングルスピーカーリファレンスオーディオを使用し、トーンとパフォーマンスを一貫して保ち、同じクローンを再利用し、生成設定を保存し、スクリプトフォーマットを標準化し、新しい出力を承認済みリファレンスと比較してください。
1つの長いナレーションを生成すべきか、それとも多くの短いクリップを生成すべきか?
管理しやすいセクションを使用してください。非常に長い生成はずれる可能性がある一方、文ごとの生成は disconnectedに聞こえる場合があります。関連する文を、再生成と編集が容易な短い論理セグメントにグループ化してください。
AIボイスの一貫性に影響する設定はどれですか?
プラットフォームによって、安定性、類似性、スタイル、スピード、ピッチ、感情、言語、およびモデルの選択がすべて表現に影響する可能性があります。すべてのクリップに対して異なる設定を調整するのではなく、承認済みプリセットを保存してください。
すべての動画で製品名が同じように発音されるようにするにはどうすればよいですか?
発音用語集を作成し、すべてのスクリプトで同じスペルまたは音声形式を使用してください。難しい名前を一度テストし、承認されたフォームを制作テンプレートの一部にしてください。
1つのAIボイスを異なる言語間で一貫して保つことはできますか?
ボイスのアイデンティティはある程度維持できる場合が多いですが、アクセントと発音が変わる場合があります。ブランドが1つのグローバルな声のアイデンティティを重視するか、よりネイティブな地域の表現を重視するかを決定し、その戦略を一貫して使用してください。


