In diesem Artikel
Prüfen Sie zuerst, ob die Musik bereits auf einer separaten Spur liegt
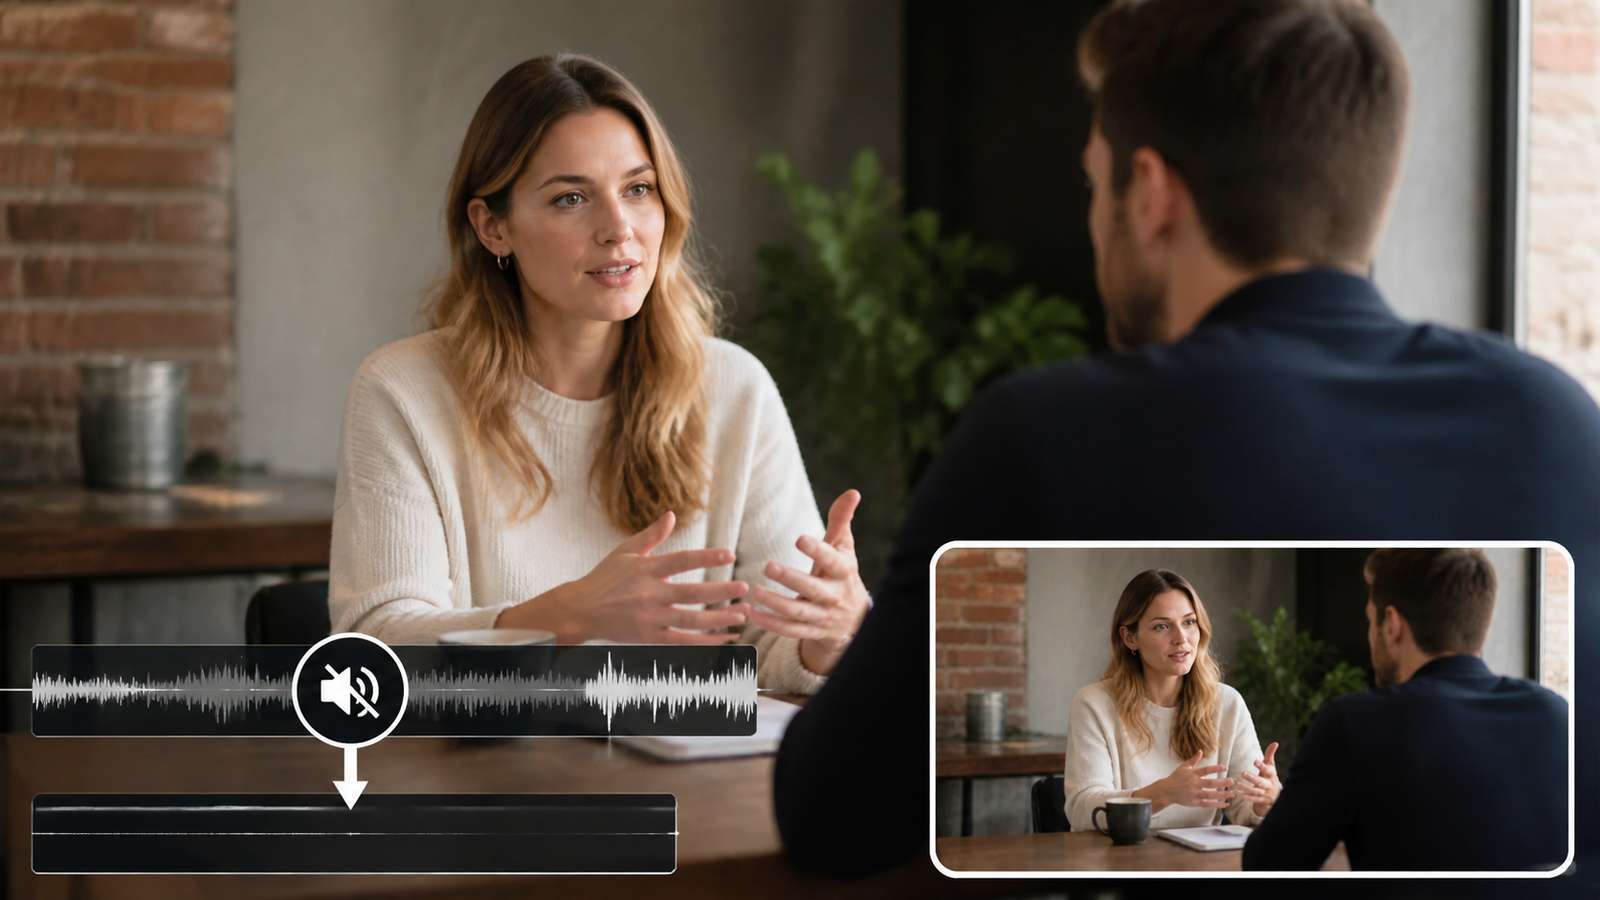
Der sauberste Weg, um Musik aus Videos zu entfernen ist überhaupt keine KI. Wenn Sie noch das Bearbeitungsprojekt haben und die Musik auf einer eigenen Timeline-Spur liegt, stummschalten oder löschen Sie diese Spur und exportieren Sie erneut. Der Dialog bleibt unberührt, da Sie eine unabhängige Audioquelle entfernen, anstatt zu versuchen, einen fertigen Soundtrack zu entmischen.
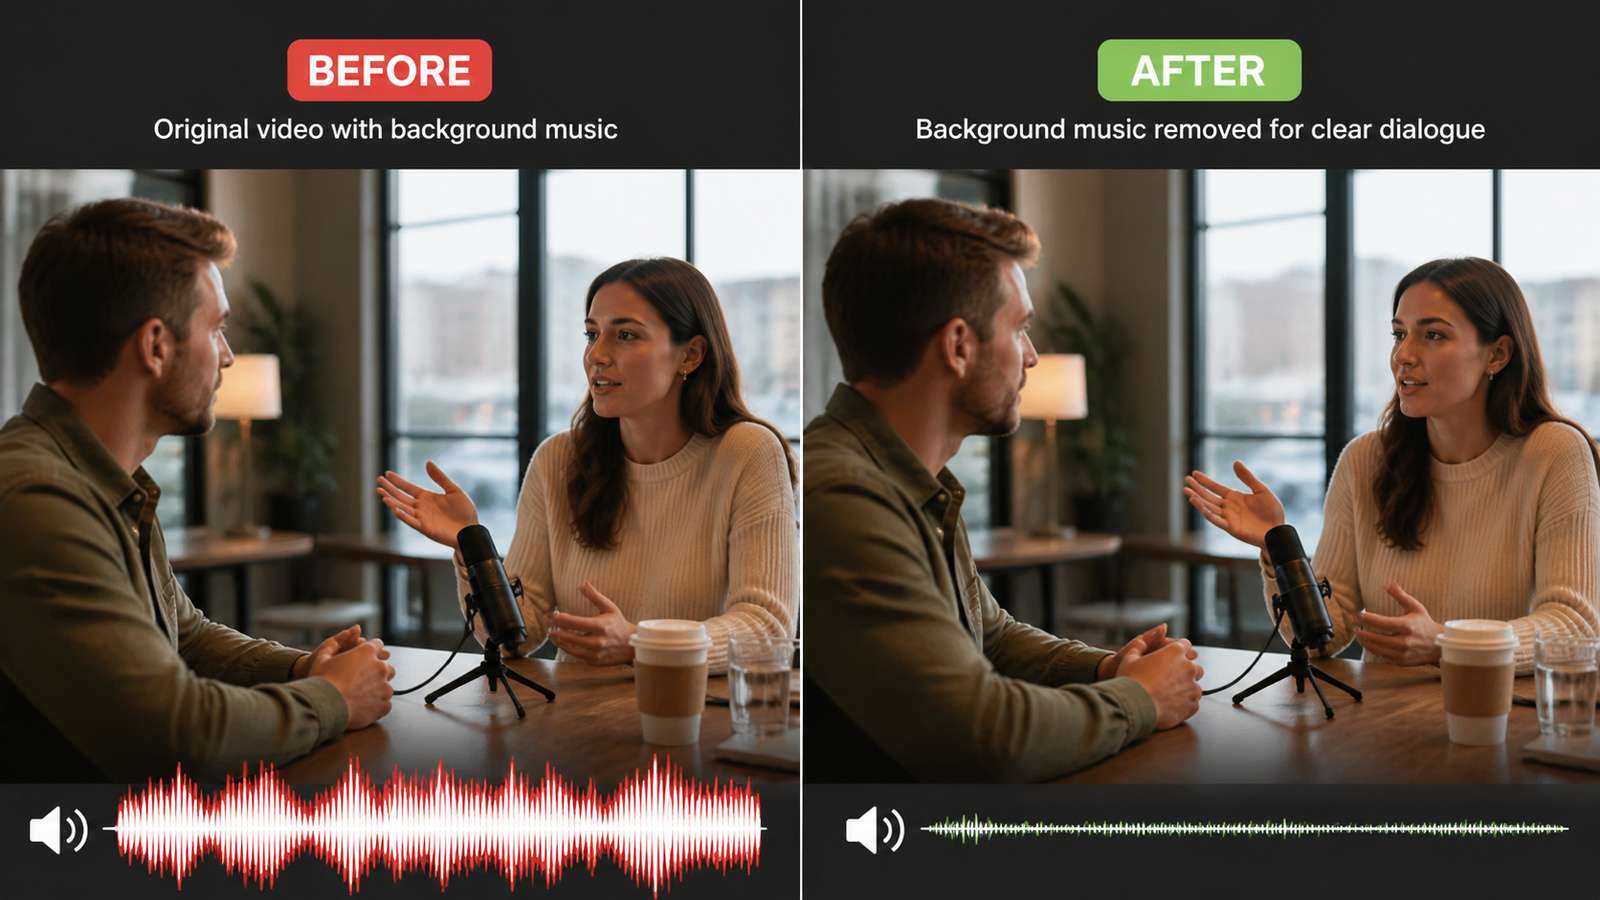
Das Problem wird nach dem Export schwieriger. In einer normalen MP4-Datei werden Sprache, Musik, Raumklang, Soundeffekte und Hall oft in dieselbe Stereospur gemischt. Die ursprünglichen Stems sind verschwunden. Ein KI-Separator kann schätzen, welche Teile wie Gesang oder Begleitung klingen, kann jedoch keinen isolierten Studio-Dialogtrack perfekt rekonstruieren, wenn alles gemeinsam gemastert wurde.
| Was Sie haben | Beste Methode | Was zu erwarten ist |
|---|---|---|
| Originalprojekt mit separater Musikspur | Musikspur stummschalten/löschen | Bestmögliches Ergebnis |
| Mehrspuraufnahme | Musik-Bus oder Stem deaktivieren | Nahezu originale Dialogqualität |
| Fertige Video mit gemischter Musik und Stimme | KI-Stem-Trennung | Meist nützlich, aber Artefakte sind möglich |
| Nur Musik, keine gewünschte Sprache | Audio stummschalten oder Soundtrack ersetzen | Keine Trennung erforderlich |
| Dialog plus lautes Lied mit Gesang | Stem-Trennung plus manuelle Nachbearbeitung | Am schwierigsten, da zwei vokalähnliche Quellen sich überlappen |
KI-Stem-Trennung verwenden, wenn der Soundtrack gemischt ist
Stem-Trennung verwendet maschinelles Lernen, um Quellen innerhalb einer gemischten Wellenform zu schätzen. Je nach Tool kann die Ausgabe in Stimme und Begleitung oder in detailliertere Stems wie Gesang, Schlagzeug, Bass und andere Instrumente aufgeteilt werden. Bei der Videoarbeit ist die nützliche Frage meist einfacher: Kann der Dialog oder die Hauptstimme nach der Reduzierung der Musik noch verständlich bleiben?
Der Separator analysiert spektrale und zeitliche Muster. Sprache hat Formanten, Konsonanten, Tonhöhenbewegungen und Pausen, die sich von vielen Instrumenten unterscheiden. Musik hat rhythmische und harmonische Strukturen. Moderne Modelle können diese überraschend gut trennen, aber die Kategorien sind nicht absolut. Ein Chor, ein Leadsänger, ein stark bearbeiteter Synthesizer oder ein Nachhallende kann Sprache ähneln. Eine laute Stimme, die in einem überfüllten Raum aufgenommen wurde, kann Hintergrundtextur ähneln.
Warum Center-Pan-Tricks nicht ausreichen
Ältere „Vokalentferner"-Methoden stützten sich oft auf Stereoauslöschung und gingen davon aus, dass der Leadgesang zentriert war, während die Instrumente links und rechts verteilt waren. Das kann bei bestimmten Musikmastern funktionieren, ist aber für Dialoge in modernen Videos unzuverlässig. KI-Trennung ist flexibler, da sie den Inhalt analysiert und nicht nur die Kanalposition. Dennoch können Phaseneffekte, Stereoambiente und überlappende Frequenzinhalte musikalische Rückstände hinterlassen.
So behalten Sie die Stimme, ohne versehentlich Soundeffekte zu löschen
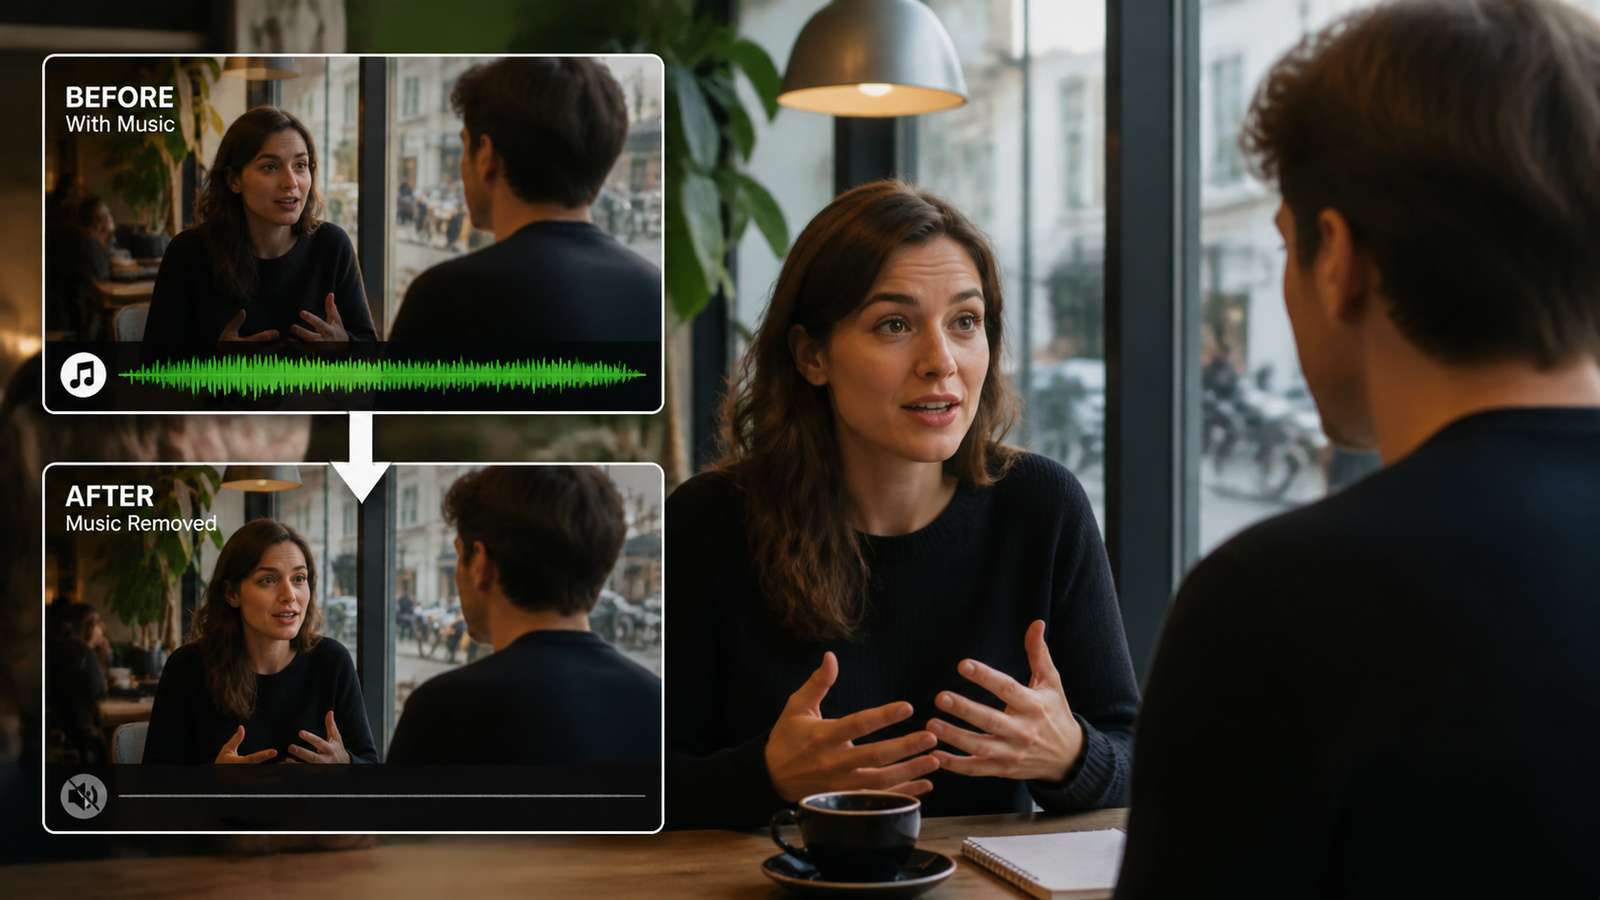
Viele Nutzer sagen „Hintergrundmusik entfernen, aber die Stimme behalten", möchten aber auch Schritte, Applaus, Verkehr, Spielgeräusche oder Raumambiente behalten. Ein Zweikanal-Separator kann einige dieser Effekte mit der Begleitung klassifizieren, sodass das Entfernen des gesamten Musik-Stems das Video unnatürlich leer wirken lassen kann. Der bessere Workflow besteht darin, zu entscheiden, was das finale Audio enthalten soll, bevor Sie irgendetwas trennen.
- Hören Sie sich zuerst den Mix an. Markieren Sie Abschnitte, wo Sprache sich mit Musik überschneidet, wo Sprache allein ist und wo Soundeffekte wichtig sind.
- Erstellen Sie Stems aus dem Audio höchster Qualität. Vermeiden Sie das wiederholte Konvertieren einer komprimierten MP3, da Artefakte für den Separator schwerer zu klassifizieren werden.
- Solieren Sie den Stimmen-Stem. Überprüfen Sie Konsonanten, Atemzüge, Raumton und ob musikalische Obertöne rund um die Sprache verbleiben.
- Nützliche Ambiente zurückbringen. Wenn der Begleitungs-Stem wichtige Umgebungsgeräusche enthält, reduzieren Sie ihn, anstatt ihn vollständig stummzuschalten, oder bauen Sie die Ambiente aus einer anderen Quelle wieder auf, die Sie verwenden dürfen.
- Abschnittsweise automatisieren. Ein Clip kann während des Dialogs eine starke Musikreduzierung benötigen und während Pausen oder Übergängen mehr Originalklang.
- Lautstärke nach der Trennung angleichen. Das Entfernen von Musik verändert die wahrgenommene Energie. Gleichen Sie den Dialogpegel aus, bevor Sie das Ergebnis beurteilen.
Für Interviews, Tutorials und Sprecherkopf-Videos ist die Verständlichkeit in der Regel wichtiger als die perfekte Erhaltung jedes Hintergrundgeräusches. Bei Film- oder Veranstaltungsaufnahmen kann die Ambiente Teil der Geschichte sein, daher ist ein sorgfältigerer Mix die zusätzliche Arbeit wert.
Warum „Musik entfernen, Stimme behalten" manchmal nicht perfektionierbar ist
Die schwierigsten Fälle sind nicht einfach „laute Musik". Es sind Fälle, bei denen die unerwünschte Musik und die gewünschte Stimme ähnliche akustische Merkmale teilen. Ein Sänger im Hintergrund kann mit Sprache verwechselt werden. Der Hall eines Sprechers kann sich über dieselben Frequenz-Zeit-Bereiche wie Pads und Streicher ausbreiten. Kompression kann Quellen zusammenkleben. Wenn der Soundtrack aggressiv gemastert wurde, hat der Separator weniger saubere Hinweise darauf, was zu welchem Originaltrack gehörte.
- Starker Hall: Die direkte Stimme kann sich trennen, während der Nachhall im Musik-Stem verbleibt, was ein unnatürlich trockenes Ergebnis erzeugt.
- Hintergrundgesang: Er kann bei der gewünschten Stimme bleiben oder den Dialog-Stem verunreinigen.
- Verzerrte Musik: Gitarren- oder Synthesizer-Obertöne können in sprachähnliche Frequenzbänder eindringen.
- Audio mit niedriger Bitrate: Codec-Verschmierung kann Konsonanten und Instrumente schwerer unterscheidbar machen.
- Dialog unter sehr lauter Musik: Teile der Sprache können im Original-Mix einfach maskiert sein und können nicht originalgetreu rekonstruiert werden.
- Schnelle Schnitte: Verschiedene Szenen können unterschiedliche akustische Profile haben, sodass eine globale Einstellung nicht überall gleich gut klingt.
Der praktische Standard sollte „sauber genug für den Zweck" sein, nicht „den ursprünglichen isolierten Dialog mathematisch wiederherstellen". Bei einem Social-Clip kann leichter musikalischer Rückstand akzeptabel sein. Bei der Transkription können Sie Sprachklarheit priorisieren, auch wenn die Stimme verarbeitet klingt. Bei einem professionellen Film-Mix ist das Auffinden der ursprünglichen Stems fast immer dem KI-Entmischen vorzuziehen.
Musik aus Videos entfernen mit Media.io AI Vocal Remover
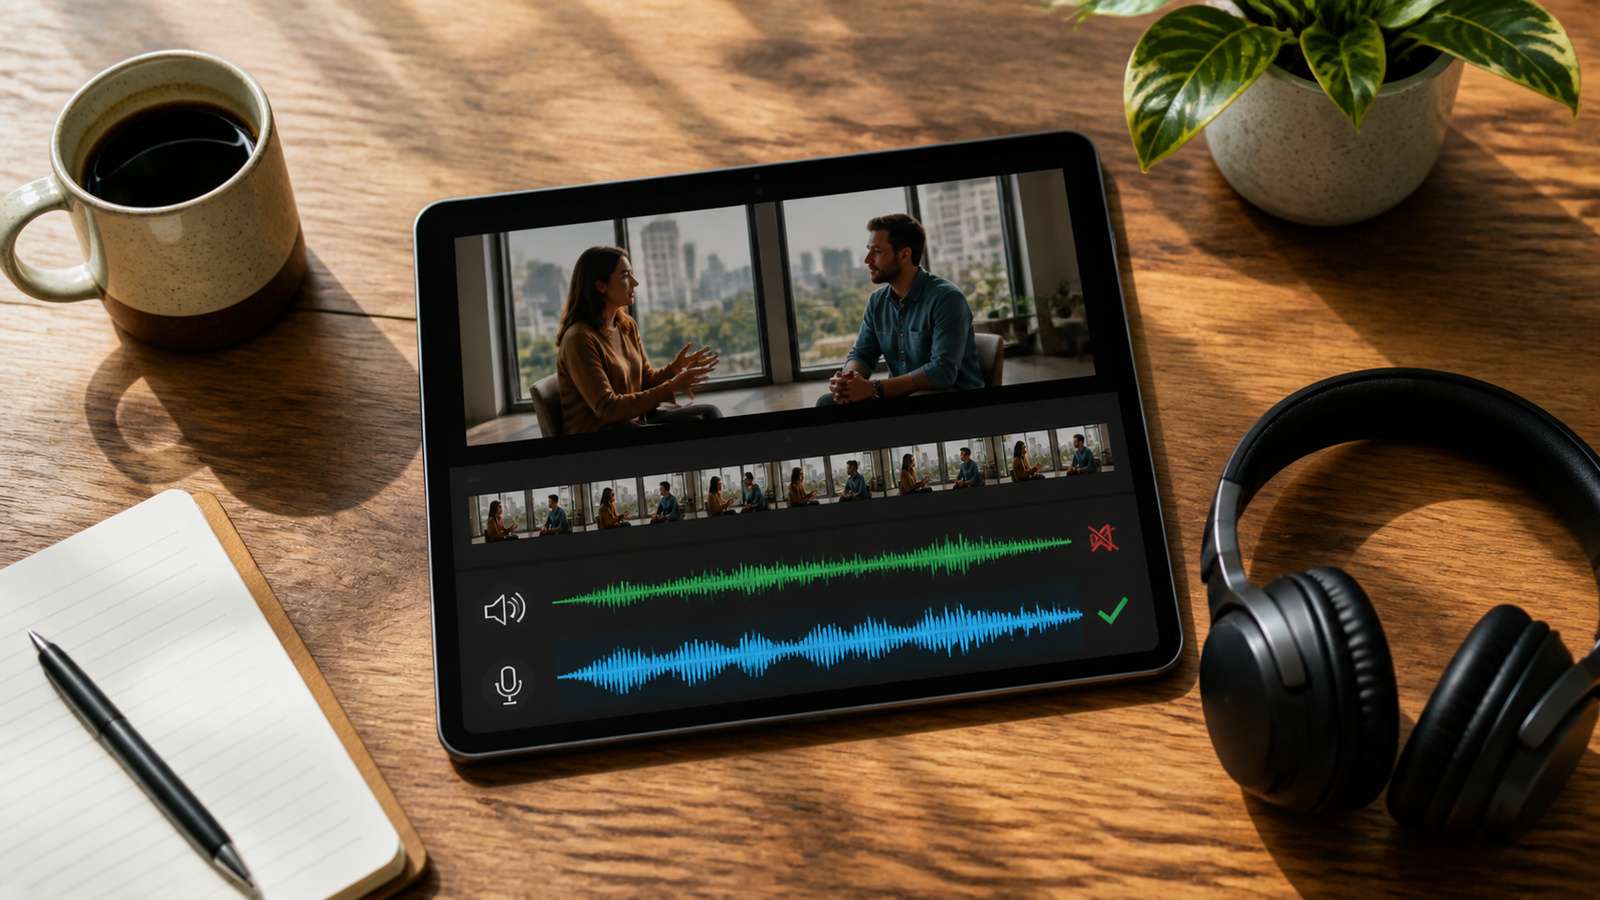
Media.io AI Vocal Remover bietet Ihnen eine browserbasierte Möglichkeit, einen gemischten Track in vokale und instrumentale Komponenten zu trennen. Für Videos besteht der nützliche Workflow darin, die Medien zu extrahieren oder hochzuladen, die Trennung durchzuführen, die resultierenden Stems anzuhören und den Stem zu behalten, der Ihrem Ziel am besten entspricht. Wenn Ihr Ziel gesprochener Dialog ist, hören Sie sorgfältig zu, da „Vokal"-Modelle in der Regel breit trainiert sind und sowohl Sprache als auch Gesang erhalten können.
- Verwenden Sie die sauberste verfügbare Quelldatei. Ein erstgenerierter Video-Export ist besser als Audio, das aus einem wiederholt komprimierten Social-Post extrahiert wurde.
- Führen Sie die Vokaltrennung durch und laden Sie beide Ausgaben herunter oder hören Sie sie an. Verwerfen Sie den Begleitungs-Stem nicht sofort; er kann Ambiente enthalten, die Sie später leise zurückmischen möchten.
- Hören Sie mit Kopfhörern einen Abschnitt an, wo sich Musik und Sprache überschneiden. Achten Sie auf wässrige Silben, fehlende Konsonanten und Musikleckage.
- Wenn die Stimme verwendbar ist, bringen Sie sie in Ihren Editor und platzieren Sie sie unter dem Original-Video. Verringern oder entfernen Sie den ursprünglichen gemischten Track.
- Fügen Sie nur die Ambiente, Effekte oder Ersatzmusik hinzu, die Sie verwenden dürfen. Normalisieren Sie dann den finalen Dialogpegel und exportieren Sie.
Wählen Sie den richtigen Export-Workflow für Ihr Ziel
| Ziel | Empfohlene Ausgabe | Zusätzlicher Schritt |
|---|---|---|
| Interview mit sauberer Sprache | Stimmen-Stem unter dem Original-Video | Leichten Raumton hinzufügen, wenn das Ergebnis zu trocken wirkt |
| Tutorial-Erzählung | Stimmen-Stem plus dezente Ersatzmusik | Ducking verwenden, damit neue Musik unter der Sprache bleibt |
| Podcast-Clip aus Video | Stimmen-Stem als WAV oder hochwertigem Audio | Rauschreduzierung und Lautstärkenormalisierung |
| Meme/Social-Remix | Stimmen-Stem plus neuer Beat | Rechte für Quell- und Ersatzaudio bestätigen |
| Transkriptgenerierung | Stimmenorientierter Stem | Klarheit ist wichtiger als musikalische Rückstände |
| Archivmaterial | Original und bearbeitete Kopie aufbewahren | Den Quell-Mix niemals löschen |
Die Exportqualität ist wichtig, da die Stammtrennung bereits Verarbeitung einführt. Wenn Sie aus einer komprimierten Datei trennen, speichern Sie das Arbeitsergebnis in einem verlustfreien Format wie WAV, bevor Sie weitere Bearbeitungen vornehmen, sofern Ihr Werkzeug dies erlaubt. Wiederholtes Konvertieren zwischen Formaten mit niedriger Bitrate kann metallische Artefakte verstärken und Konsonanten abschwächen.
Häufige Artefakte und Fehlerbehebung
| Artefakt | Wie es klingt | Was ausprobiert werden sollte |
|---|---|---|
| Musik-Durchblutung | Leise Schlagzeuge, Synthesizer oder Akkorde unter der Sprache | Den Stamm selektiv reduzieren, anstatt den gesamten Clip übermäßig zu verarbeiten |
| Wässrige Stimme | Wirbelnde oder phasige Silben | Von einer besseren Quelle beginnen; weniger aggressive Bereinigung verwenden |
| Fehlende Konsonanten | Sprache wird dumpf oder schwer verständlich | Eine kleine Menge der Originalspur unter dem Stamm einmischen |
| Zu trockener Dialog | Stimme klingt vom Raum losgelöst | Sauberen Raumton oder subtilen Hall hinzufügen |
| Pumpender Pegel | Stimme ändert die Lautstärke bei Musikeinsätzen | Lautstärkeautomatisierung und sanfte Kompression nach der Trennung verwenden |
| Hintergrundgesang bleibt erhalten | Gesang wird mit gewünschter Sprache klassifiziert | Einen anderen Trennungsmodus/ein anderes Modell ausprobieren oder den Problemabschnitt manuell bearbeiten |
Immer mit dem Original vergleichen. Es ist leicht, sich darauf zu konzentrieren, die Musik zu entfernen und versehentlich eine Stimme zu akzeptieren, die viel weniger natürlich ist. Für KI-generierte Videos ist natürlicher Klang ebenfalls ein wichtiger Teil des Realismus – siehe unseren Leitfaden für realistisch wirkende KI-Videos für Tipps zur Abstimmung von Klang mit Szene und Bewegung. Wenn die getrennte Stimme technisch „sauber" ist, aber anstrengend zu hören ist, kann eine kontrollierte Reduzierung der Originalmusik besser klingen als die vollständige Entfernung.
Drei praktische Mischszenarien
Talking-Head-Video mit leiser Hintergrundmusik. Nicht davon ausgehen, dass eine vollständige Stammtrennung notwendig ist. Wenn die Musik bereits deutlich leiser als der Sprecher ist, können herkömmliche Klangregelung, Dialogverbesserung und sanfte Musikreduzierung natürlicher klingen als eine aggressive Quelltrennung. KI einsetzen, wenn die Musik die Verständlichkeit beeinträchtigt oder wenn wirklich eine reine Sprachversion benötigt wird.
Veranstaltungsaufnahmen mit Sprache, Applaus und Musik. Ein Zwei-Stamm-Trenner kann Applaus und Publikumsgeräusche in die Begleitung einordnen. Wenn dieser Stamm vollständig stummgeschaltet wird, kann das Ergebnis so klingen, als wäre der Sprecher in einem Vakuum aufgenommen worden. Eine bessere Mischung kann eine leise Menge des Originals oder Begleitstamms unter der bereinigten Stimme behalten. Lautstärkeautomatisierung bei Applaus und Übergängen verwenden, anstatt einen festen Pegel für den gesamten Clip.
Song unter Erzählung. Dies ist schwierig, wenn der Song selbst Gesang enthält. Der Trenner kann sowohl den Erzähler als auch den Sänger als „Stimme" behandeln. Wenn die Erzählung das einzige gewünschte Element ist, die Zeitbereiche isolieren, in denen der Erzähler spricht, ein anderes Trennungsmodell ausprobieren oder den Soundtrack mit lizenzierter Instrumentalmusik neu aufbauen. Die Verarbeitungsstärke nicht weiter erhöhen, wenn dadurch der Erzähler zerstört wird.
So beurteilen Sie das Ergebnis objektiv
Dasselbe zehn bis zwanzig Sekunden lange Testsegment für jeden Versuch verwenden. Eine leise Sprachphrase, einen lauten Konsonanten und einen Abschnitt einbeziehen, in dem Musik und Stimme sich überlagern. Die Wiedergabelautstärke vor dem Vergleich der Versionen anpassen; lauteres Audio klingt oft „besser", auch wenn es mehr Artefakte enthält. Einmal mit Kopfhörern auf Durchblutung und einmal auf gewöhnlichen Telefon- oder Laptop-Lautsprechern auf Verständlichkeit hören. Die Version, die auf beiden Systemen am natürlichsten klingt, ist in der Regel die bessere praktische Bearbeitung.
Häufig gestellte Fragen zum Entfernen von Musik aus Videos
-
Kann ich Hintergrundmusik aus einem Video entfernen und die Sprache behalten?
Ja, besonders wenn die Sprache prominent ist und die Musik nicht zu dicht ist. KI-Stammtrennung schätzt einen Sprachstamm, aber das Ergebnis kann Artefakte enthalten, wenn sich die Quellen stark überlagern. -
Was ist, wenn ich noch das ursprüngliche Bearbeitungsprojekt habe?
Die Musikspur dort stummschalten oder löschen. Das ist sauberer als das Trennen eines fertigen Mixes, da Sprache und Musik bereits unabhängig sind. -
Behält ein Vokal-Entferner Soundeffekte?
Nicht immer. Viele Werkzeuge trennen grob in Gesang und Begleitung. Einige gewünschte Klangfarben oder Effekte können im Begleitstamm landen, daher beide Ausgaben vor dem Mischen anhören. -
Warum klingt meine Stimme nach dem Entfernen der Musik metallisch?
Der Trenner kann Sprache aus stark überlagertem oder komprimiertem Audio rekonstruieren. Bessere Quellqualität, leichtere Verarbeitung und eine kleine Beimischung des Originals können manchmal natürlicher klingen. -
Kann ich nur die Musik in einem Abschnitt entfernen?
Ja. Das Audio trennen, dann die Stämme nach Zeitbereich automatisieren oder bearbeiten. Es muss nicht dieselbe Menge an Entfernung auf das gesamte Video angewendet werden. -
Ist es besser, die Musik zu ersetzen, anstatt sie zu entfernen?
Für viele Social-Media- oder Tutorial-Videos ja. Die bereinigte Stimme behalten, einen neuen lizenzierten Track hinzufügen und dessen Pegel mit Ducking oder Lautstärkeautomatisierung steuern.