Wenn sich der Erzähler bei jedem Szenenwechsel leicht verändert, bemerkt das Publikum dies, auch wenn es nicht erklären kann warum.Stimmkonsistenz betrifft nicht nur die Klangfarbe. Tempo, Akzent, Atemgeräusche, Emotion, Aussprache, Lautstärke und Raumcharakter können dazu führen, dass sich derselbe synthetische Sprecher wie eine andere Person anfühlt.
Curious Refuge vergleicht diese drei Arbeitsabläufe in einem speziellen Tutorial zur Stimmkonsistenz. Schauen Sie sich zuerst den Kontrast an und nutzen Sie dann den Rest dieses Leitfadens, um die bevorzugte Stimme in eine wiederholbare Serienspezifikation mit kontrollierten Skripten, Einstellungen, mehrsprachiger Darbietung, Normalisierung und Qualitätssicherung umzuwandeln.
In diesem Artikel
- Definieren Sie, was „dieselbe Stimme" für Ihr Projekt bedeutet
- Verwenden Sie dasselbe Stimm-Asset, nicht ein ähnliches
- Beginnen Sie mit sauberem und konsistentem Referenzaudio
- Sperren Sie die Stimmeinstellungen für die gesamte Serie
- Standardisieren Sie das Skript, bevor Sie Audio generieren
- Generieren Sie in überschaubaren Segmenten
- Halten Sie den emotionalen Bereich bewusst
- Stimmen Sie die Stimme sorgfältig über Sprachen hinweg ab
- Normalisieren Sie das fertige Audio, nicht nur die Generator-Einstellungen
- Verwenden Sie einen Stimm-Referenzclip während der Qualitätssicherung
- Erstellen Sie einen wiederholbaren Media.io-Stimm-Workflow
- Checkliste für KI-Stimmkonsistenz
- Halten Sie Modell- und Workflow-Versionen unter Kontrolle
- Häufig gestellte Fragen zur KI-Stimmkonsistenz
Definieren Sie, was „dieselbe Stimme" für Ihr Projekt bedeutet
Stimmidentität ist nur ein Teil der Konsistenz. Zwei Clips können dieselbe synthetische Stimme verwenden und dennoch wie verschiedene Produktionen klingen.
Definieren Sie das Ziel in mehreren Dimensionen:
| Konsistenzdimension | Was zu sperren ist |
| Stimmidentität | Klangfarbe, Akzent, scheinbares Alter und Kerncharakter. |
| Darbietung | ruhig, energetisch, gesprächig, autoritär oder verspielt. |
| Tempo | ungefähre Wörter pro Minute und Pausenstil. |
| Emotion | neutrale Grundlage und erlaubter emotionaler Bereich. |
| Aufnahmecharakter | trockenes Studio, warme Kabine, nahes Mikrofon oder ein anderer konsistenter Klang. |
| Lautstärke | ein Zielpegel für endgültige Exporte. |
| Aussprache | Namen, Akronyme, Produkte, Orte und Fachbegriffe. |
Schreiben Sie diese in eine Stimmspezifikation. Eine nützliche Spezifikation könnte lauten: „Warme weibliche Erzählerin, klares neutrales amerikanisches Englisch, mittleres Tempo, selbstbewusst aber nicht verkäuferisch, kurze Pausen zwischen Sätzen, keine übertriebenen Atemgeräusche, trockener Studioklang, konsistente Aussprache von Produktnamen."
Die Stimmspezifikation wird zur Referenz für jedes Skript und jeden Qualitätssicherungsdurchgang.
Verwenden Sie dasselbe Stimm-Asset, nicht ein ähnliches
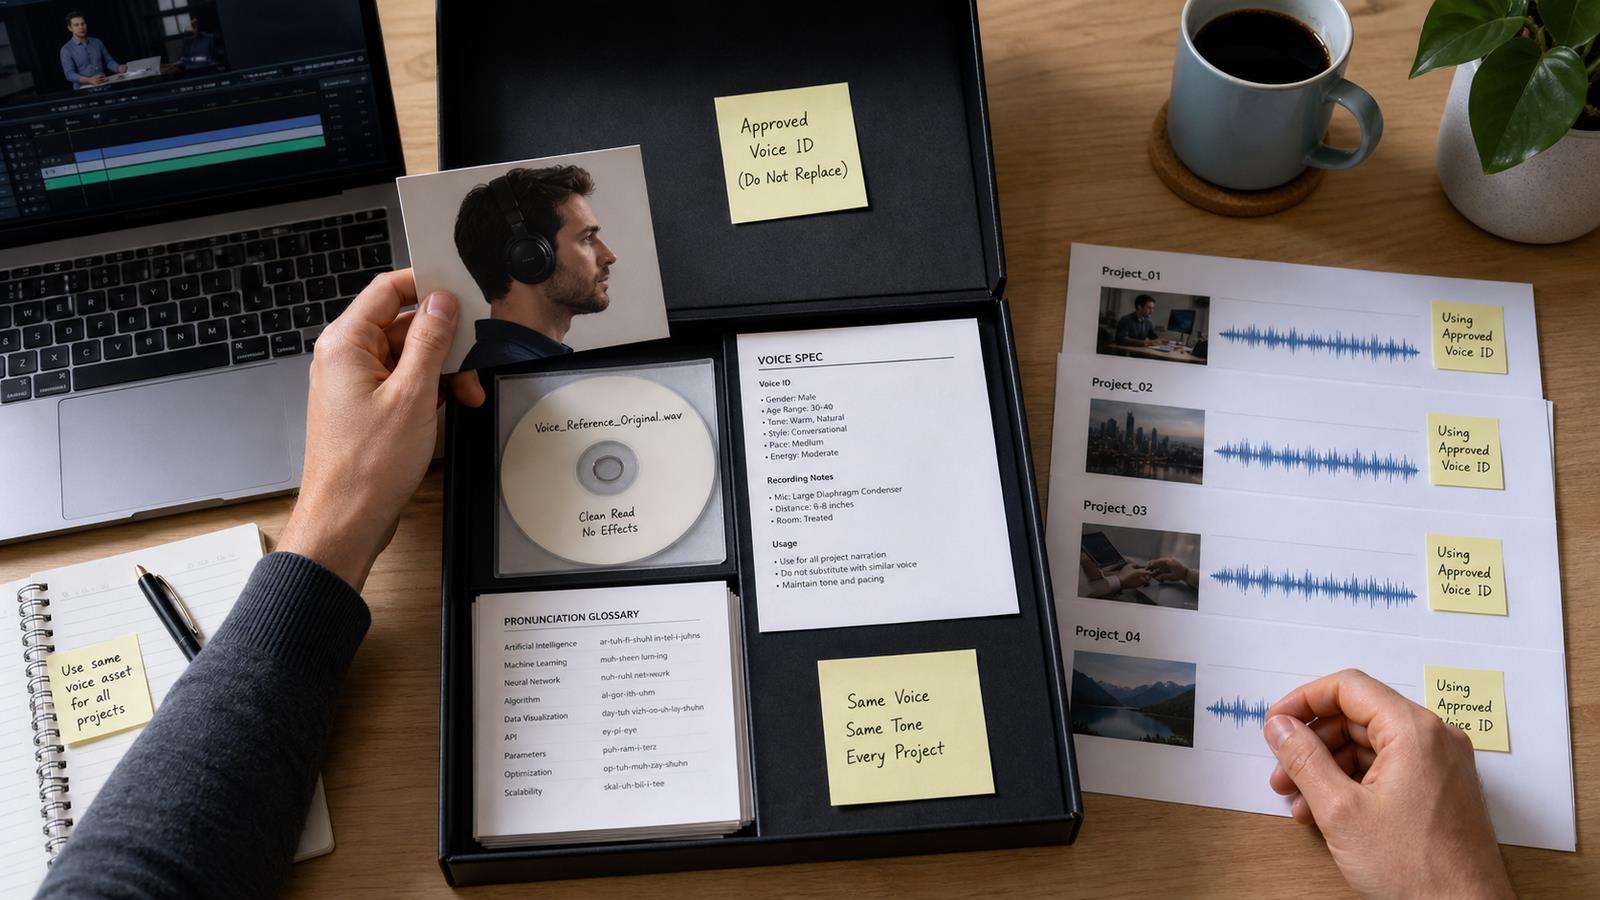
Wenn eine Plattform eine Stimm-ID, eine gespeicherte Stimme oder eine geklonte Stimme bereitstellt, verwenden Sie dasselbe Asset über die gesamte Serie hinweg. Wählen Sie keine neue Stimme, weil ihre Vorschau ähnlich klingt.
Bewahren Sie für geklonte Stimmen die originalen Quellaufnahmen auf. ElevenLabs weist darauf hin, dass die Neuerstellung eines Klons aus denselben Proben dennoch einen leicht anderen Klon erzeugen kann. Das ist ein weiterer Grund, das genehmigte Stimm-Asset zu erhalten, anstatt es später neu zu erstellen.
Der KI-Stimmklonung-Workflow von Media.io kann verwendet werden, um eine wiederverwendbare Stimme für Erzählung, Marketing, Bildung oder Video-Vertonung zu erstellen. Wenn Konsistenz wichtig ist, behandeln Sie den genehmigten Klon als benanntes Produktions-Asset und zeichnen Sie auf, welche Projekte ihn verwenden.
Beginnen Sie mit sauberem und konsistentem Referenzaudio
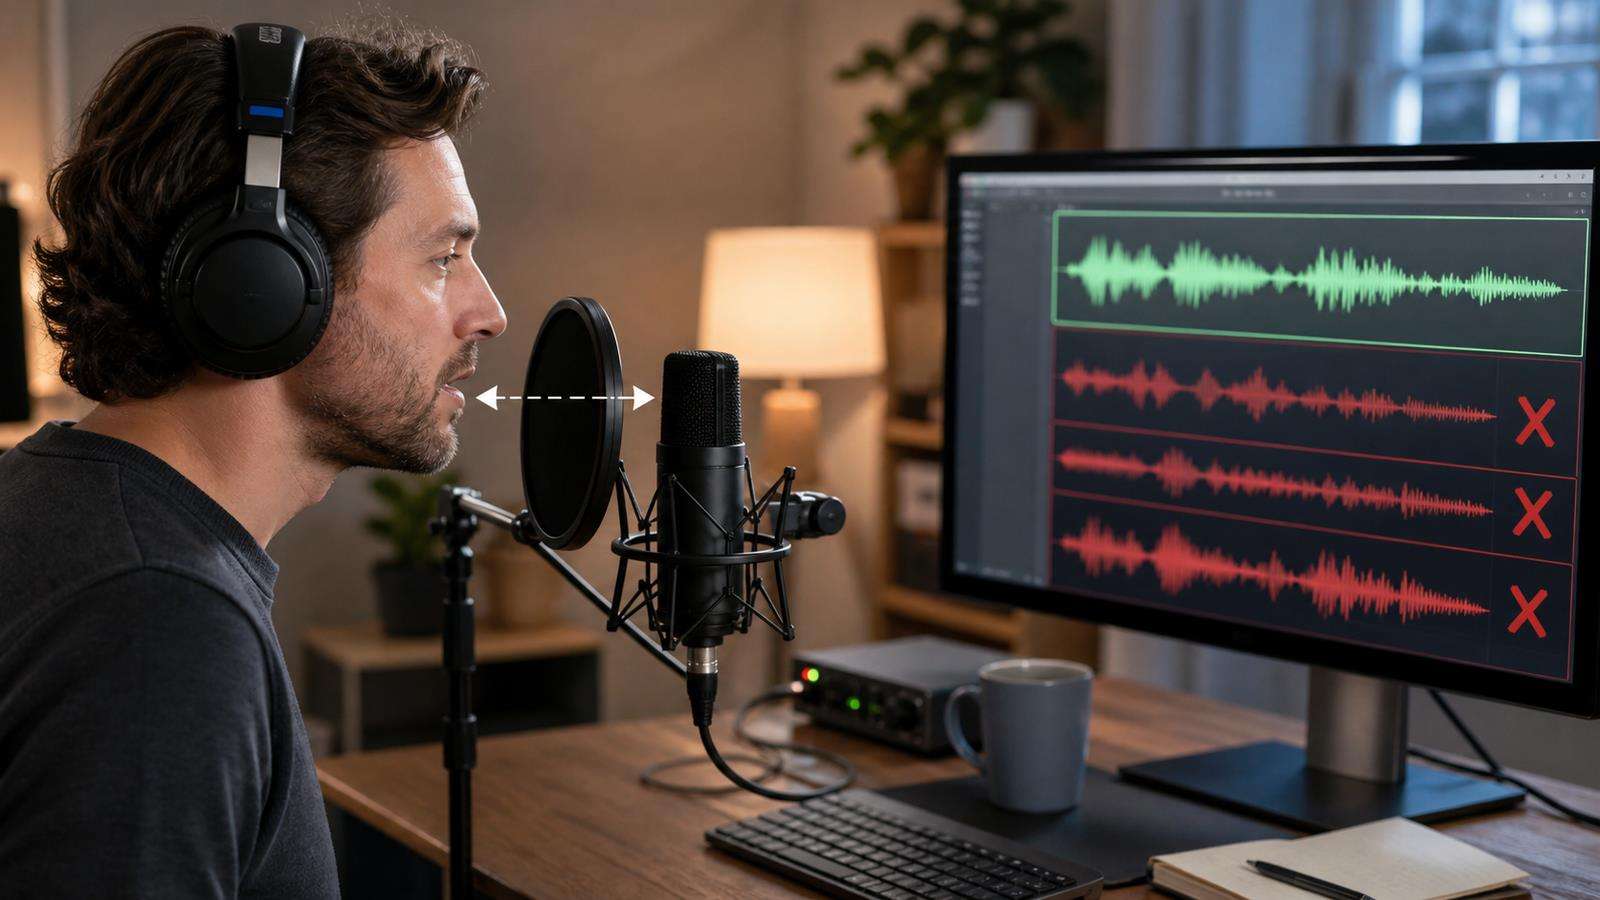
Ein Klon lernt aus dem, was er hört. Hintergrundgeräusche, Raumhall, wechselnde Mikrofone, große Lautstärkeschwankungen und gemischte Darbietungsstile können die generierte Stimme weniger vorhersehbar machen.
ElevenLabs empfiehlt saubere Einzelsprecheraufnahmen mit konsistenter Lautstärke, Ton, Audioqualität und Darbietung. Für seinen Instant Voice Cloning-Workflow empfiehlt es etwa ein bis zwei Minuten gutes Audio. Professionelles Klonen erfordert viel mehr Material, aber das wichtige Prinzip ist dasselbe: Qualität und Konsistenz sind wichtiger als das zufällige Sammeln von Sprechminuten.
Nehmen Sie die Stimme auf, die Sie tatsächlich reproduzieren möchten. Wenn das Ziel ein ruhiger Unternehmenserzähler ist, mischen Sie Flüstern, Schreien, Charakterschauspielerei und beiläufige Telefonaufnahmen nicht in demselben Referenzsatz. Wenn Sie mehrere emotionale Modi wünschen, verwalten Sie diese bewusst, anstatt die Trainingsdaten zu einer zufälligen Mischung werden zu lassen.
Sperren Sie die Stimmeinstellungen für die gesamte Serie
Viele TTS-Systeme zeigen Kontrollen, die die Konsistenz beeinträchtigen. Die Namen unterscheiden sich je nach Plattform, aber gängige Kontrollen umfassen Stabilität, Ähnlichkeit, Stil, Geschwindigkeit, Tonhöhe, emotion und Sprache.
Notieren Sie die für den genehmigten clip verwendeten Einstellungen. Wenn Sie die Stabilität oder den Stil von einem video in ein anderes ändern, ändern Sie absichtlich das Sprachverhalten.
ElevenLabs beschreibt Stabilität als eine Kontrolle darüber, wie eng die Ausgabe an die Referenz anhält und wie viel Zufälligkeit zwischen den Generationen erscheint. Es warnt auch davor, dass eine stärkere Stilübertreibung die Stabilität verringern kann. Das ist eine nützliche allgemeine Lektion: Einstellungen, die auf Ausdrucksfähigkeit ausgelegt sind, können eine Serie weniger einheitlich machen.
Für die Produktion eine Basisvoreinstellung festlegen. Erstellen Sie separate benannte presets nur dann, wenn der Inhalt sie wirklich benötigt, wie z.Erzähler_neutral, Erzähler_aufgeregt, undErzähler_Soft. Passen Sie die Schieberegler nicht durch Fühlen auf jedem clip an.
Media.ioText zu SpracheErmöglicht auch Stimme, Sprache, Geschwindigkeit und Tonhöhe. Halten Sie diese Entscheidungen aufgezeichnet, wenn eine Folge von videos einen Erzählstil teilen muss.
Standardisieren Sie das Skript, bevor Sie Audio generieren
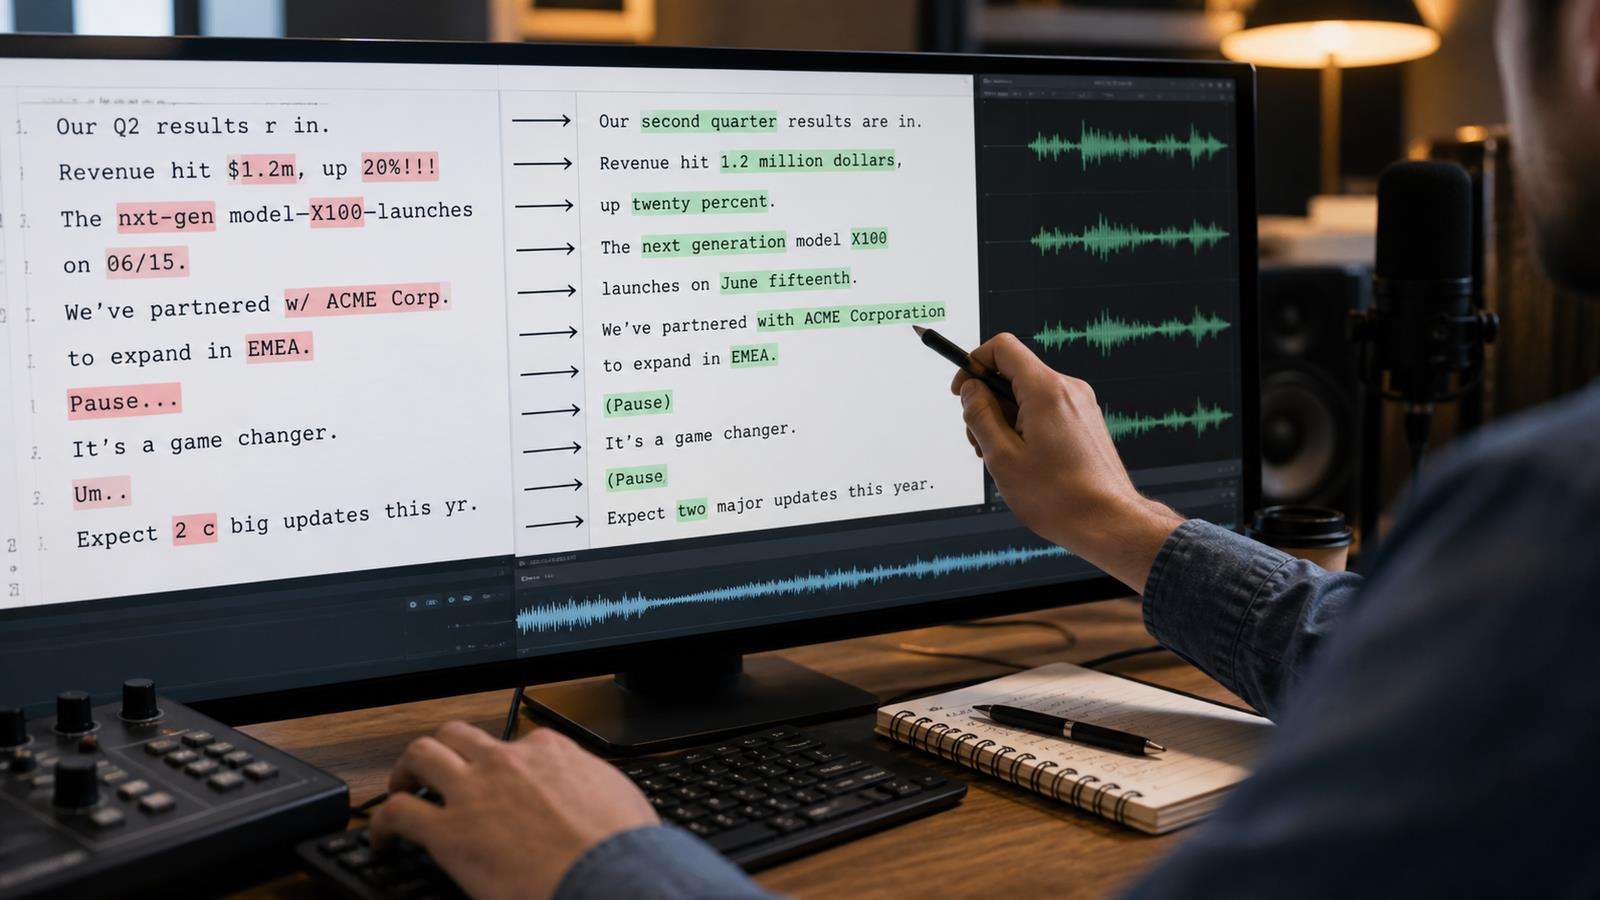
Sprachvariationen können durch die Textformatierung entstehen, nicht nur durch das Sprachmodell.
Skriptregeln erstellen für:
- Satzlänge.
- Zeichensetzung Stil.
- Zahlen und Termine.
- Abkürzungen.
- Produktnamen.
- URLs.
- Pausen.
- Betonung.
- Fremdwörter.
Wenn eine Schrift "2026" und eine andere "twenty-six" schreibt, kann die Aussprache unterschiedlich sein. Wenn einer "AI" und ein anderer "A.I." verwendet, kann sich die Kadenz ändern. Wenn der gleiche Produktname manchmal mit Bindestrich und manchmal nicht versehen ist, kann das Modell ihn anders aussprechen.
Erstellen Sie ein Aussprache-Glossar. Schreiben Sie knifflige Begriffe phonetisch aus, wenn das system es unterstützt, oder verwenden Sie eine stabile Textform, die Sie bereits getestet haben.
Generieren Sie in überschaubaren Segmenten
Lange Generationen können in Energie, Lautstärke, Tempo oder Aussprache schwanken. Wenn Sie ein Skript in kleinere logische Segmente aufteilen, ist es einfacher, nur die schwache Zeile zu regenerieren und sie mit einer Referenz zu vergleichen.
Die Fehlerbehebungsanleitung von ElevenLabs schlägt speziell vor, text in kleinere Segmente aufzuteilen, wenn Volumen oder Qualität über längere Generationen variiert. Ein segment kann ein Absatz, eine Szene oder 10 bis 30 Sekunden Erzählung sein, je nach tool und Inhalt.
Machen Sie nicht jeden Satz zu einer separaten Datei, es sei denn, die Leistung wird zu schräg. Gruppieren Sie Sätze, die zu einem Gedanken gehören, damit die Prosodie natürlich fließen kann. Lassen Sie die Bearbeitungsgriffe am Anfang und am Ende für die timing.
Nennen Sie Dateien systematisch, zum Beispiel:
EP04_S03_VO_01.wav
EP04_S03_VO_02.wav
Dadurch ist es einfach, eine Zeile zurück zum Skript zu verfolgen und nur das notwendige segment zu regenerieren.
Halten Sie den emotionalen Bereich bewusst
Konsistenz bedeutet keine monotone Lieferung. Ein Erzähler kann aufgeregt für eine Enthüllung klingen und ruhiger für eine Erklärung, während er immer noch die gleiche Stimme behält. Der Schlüssel besteht darin, den Bereich zu definieren.
Erstellen Sie eine kleine emotionale Karte für die Serie:
- Hook: Energische, kurze Sätze.
- Erklärung: neutral und klar.
- Warnung: langsamer und ernster.
- CTA: warm, selbstbewusst, nicht geschrien.
Wenn ein clip plötzlich eine Theateraufführung verwendet, die es nirgendwo sonst gibt, klingt es wie ein anderer Erzähler. Halten Sie den emotionalen Stil mit der Grundstimme verbunden.
Wenn das system sehr ausdrucksstarke Steuerelemente bietet, generieren Sie mehrere Kandidaten und wählen Sie den, der Ihrer zugelassenen Referenz am nächsten liegt. Gehen Sie nicht davon aus, dass die dramatischste Aufnahme die beste ist.
Stimmen Sie die Stimme sorgfältig über Sprachen hinweg ab
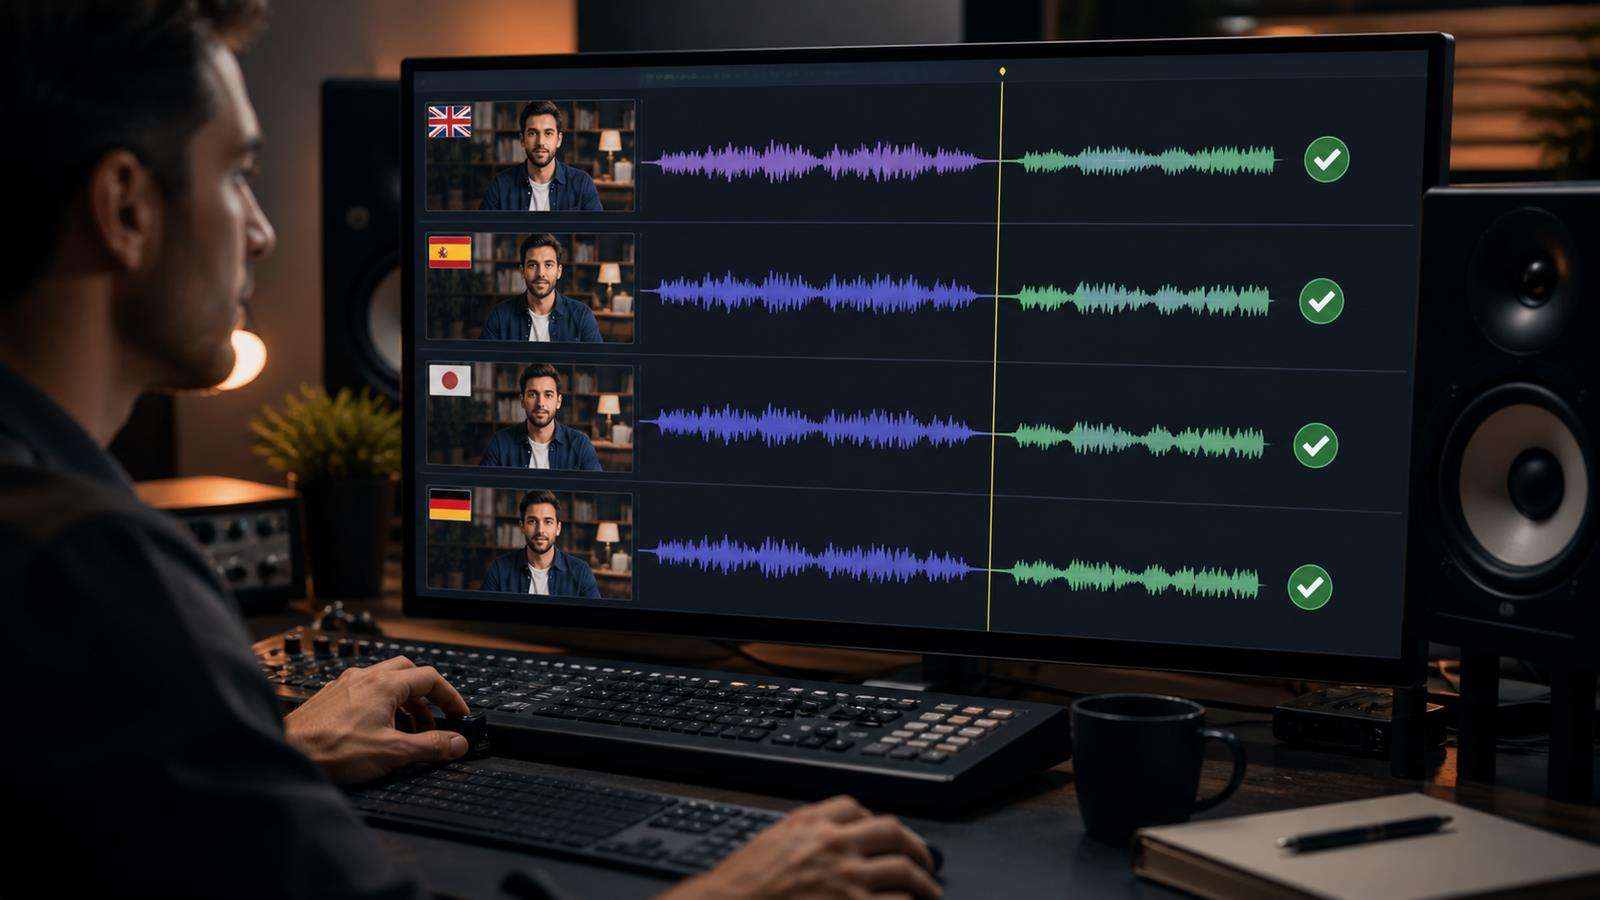
Mehrsprachige Produktion führt eine weitere Schicht ein. Eine klonierte englische Stimme, die Spanisch oder Japanisch spricht, kann eine gewisse Identität bewahren, aber Akzent, Rhythmus oder Aussprache ändern. ElevenLabs stellt fest, dass klonierte Stimmen den Akzent der in den Quellaufnahmen verwendeten Sprache tragen können, wenn sie eine andere Sprache sprechen.
Entscheiden Sie, was Konsistenz über Märkte hinweg bedeutet. Sie können eine globale Sprachidentität priorisieren, oder Sie können native lokale Bereitstellung mit verschiedenen Zielsprachen priorisieren. Beide sind gültige Markenstrategien.
Für ein vorhandenes Gesprächsvideo, Media.io'sKI LippensynchronisierungKann Ersatzaudio mit dem sichtbaren Lautsprecher synchronisieren. Für einen stillen Moderator,KI sprechen AvatarKann Sprache aus einem Bild und Skript oder audio erstellen.
Normalisieren Sie das fertige Audio, nicht nur die Generator-Einstellungen
Zwei Clips können identische TTS-Einstellungen verwenden und nach der Bearbeitung dennoch unterschiedlich laut wahrgenommen werden. Hintergrundmusik, Kompression, Rauschunterdrückung und Videoexporteinstellungen beeinflussen den endgültigen Klang.
Erstellen Sie ein Audio-Finishing-Preset für die Serie. Überprüfen Sie mindestens:
- Lautstärke.
- Spitzenpegel.
- Rauschpegel.
- Equalizer.
- Kompression.
- De-Essing bei Bedarf.
- Raumton oder Ambiente.
- Musikpegel unter der Sprachausgabe.
Wenden Sie dieselbe Finishing-Kette an, es sei denn, ein Clip hat einen bestimmten Grund, davon abzuweichen. Wenn einige Quellenreferenzen Rauschen enthalten, bereinigen Sie diese, bevor Sie klonen. Der KI-Rauschunterdrücker von Media.io kann bei der Bereinigung helfen, wenn unerwünschte Hintergrundgeräusche Teil der Quelle oder der finalen Tonspur sind.
Verwenden Sie einen Stimm-Referenzclip während der Qualitätssicherung
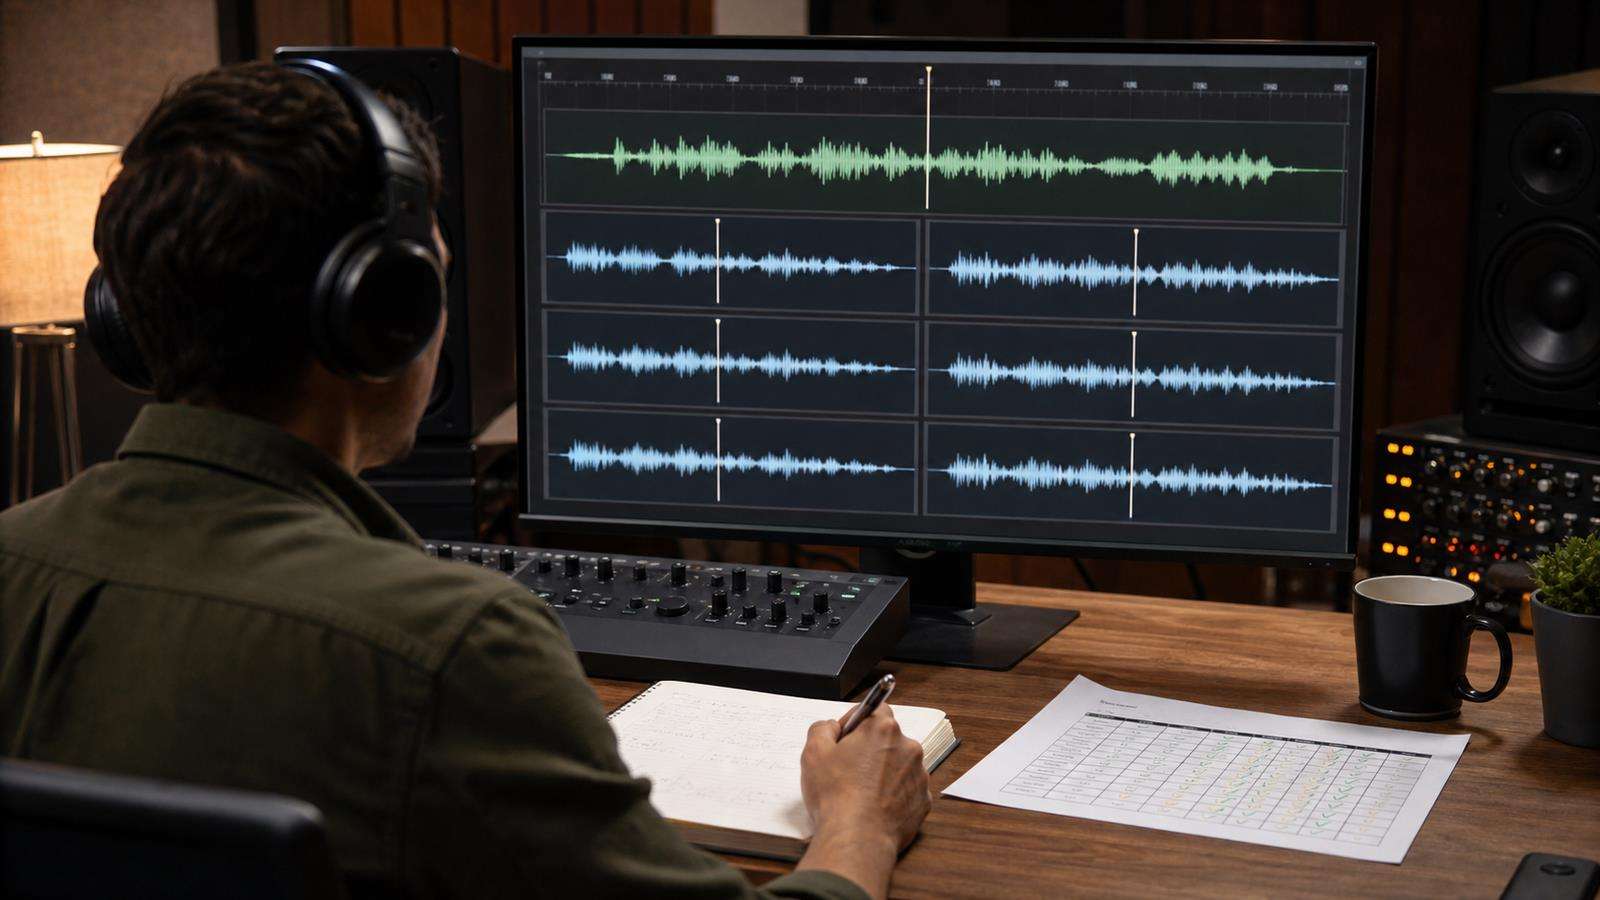
Verlassen Sie sich nicht auf das Gedächtnis. Halten Sie bei jeder Überprüfungssitzung eine kurze genehmigte Sprachreferenz bereit. Spielen Sie die Referenz ab und dann den neuen Clip.
Vergleichen Sie:
- Akzent und Klangfarbe.
- Tempo.
- Emotionale Energie.
- Aussprache.
- Behauchung.
- Lautstärke.
- Raum- oder Verarbeitungscharakter.
Ein direkter Vergleich macht kleine Abweichungen viel leichter hörbar. Erstellen Sie für eine umfangreiche Serie eine Kontaktreel mit je einem Satz aus jeder Episode. Das aufeinanderfolgende Abhören der Samples deckt allmähliche Veränderungen auf, die bei der isolierten Freigabe möglicherweise nicht auffallen.
Erstellen Sie einen wiederholbaren Media.io-Stimm-Workflow
Erstellen oder wählen Sie für einen stabilen Sprecher die Stimme einmal aus und halten Sie dann Ihre Einstellungen und Skriptkonventionen konsistent. Generieren Sie den Sprachkommentar in überschaubaren Abschnitten, vergleichen Sie ihn mit der genehmigten Referenz und fügen Sie das endgültige Audio in den Video-Workflow ein.
Wenn Sie einen wiederverwendbaren Klon benötigen, beginnen Sie mit Media.io KI-Stimmklonen. Wenn Sie eine fertige Stimme mit Geschwindigkeits- und Tonhöhensteuerung benötigen, verwenden Sie Text zu Sprache. Wenn das fertige Video bereits ein sprechendes Gesicht enthält, verwenden Sie Lip Sync, nachdem das lokalisierte oder korrigierte Audio genehmigt wurde.
Checkliste für KI-Stimmkonsistenz
Bestätigen Sie vor der Veröffentlichung einer Reihe von Clips:
- Dieselbe genehmigte Stimme oder derselbe Klon wird durchgehend verwendet.
- Das Referenzaudio ist sauber und konsistent.
- Spracheinstellungen werden gespeichert und nur bei dokumentierten Änderungen angepasst.
- Die Skriptformatierung folgt einem einheitlichen Standard.
- Produktnamen und schwierige Begriffe folgen einem Aussprache-Glossar.
- Lange Skripte werden in überschaubare Segmente unterteilt.
- Die emotionale Darbietung bleibt im genehmigten Rahmen.
- Das endgültige Audio verwendet denselben Lautstärke- und Verarbeitungsansatz.
- Jeder neue Clip wird mit einem Referenzsample verglichen.
- Mehrsprachige Versionen folgen einer gezielten Strategie zwischen Markenidentität und nativer Aussprache.
Eine konsistente KI-Stimme entsteht nicht durch eine einzige perfekte Einstellung. Sie ist das Ergebnis einer wiederholbaren Pipeline, die Eingabe, Generierung, Skript, Darbietung und Nachbearbeitung steuert.
Halten Sie Modell- und Workflow-Versionen unter Kontrolle
Eine Stimme kann abweichen, selbst wenn Skript und Einstellungen gleich bleiben, wenn sich das zugrunde liegende Sprachmodell ändert. Produktionswerkzeuge verbessern sich im Laufe der Zeit, und ein neues Modell kann Emotionen, Pausen, Aussprache oder das Klonen anders handhaben. Notieren Sie die Modell- oder Workflow-Version, die für eine genehmigte Serie verwendet wurde, wenn die Plattform diese Information bereitstellt.
Bevor Sie einen langjährigen Kanal auf ein neues Modell migrieren, generieren Sie ein kurzes Benchmark-Skript mit der alten und neuen Konfiguration. Schließen Sie die Produktnamen, Zahlen, den emotionalen Bereich und die Satzmuster ein, die häufig in der Serie vorkommen. Vergleichen Sie beide Versionen mit der genehmigten Referenzstimme, bevor Sie die gesamte Pipeline umstellen.
Wenn das neue Modell besser, aber hörbar anders ist, behandeln Sie die Änderung wie eine Rebranding-Entscheidung. Aktualisieren Sie entweder die gesamte Serie ab einem geplanten Punkt oder behalten Sie den alten Workflow für vorhandene Inhalte bei, bis ein sauberer Übergang möglich ist. Stille Modelländerungen sind ein Grund dafür, dass ein Sprecher sich im Laufe der Zeit scheinbar verändert, obwohl niemand absichtlich die Stimme geändert hat.
Häufig gestellte Fragen zur KI-Stimmkonsistenz
Warum klingt dieselbe KI-Stimme zwischen Clips unterschiedlich?
KI-Sprachgenerierung ist nicht vollständig deterministisch. Unterschiede in Referenzaudio, Text, Interpunktion, Einstellungen, emotionaler Richtung, Segmentlänge und Nachbearbeitung können das Ergebnis beeinflussen.
Wie halte ich eine geklonte Stimme konsistent?
Verwenden Sie sauberes Referenzaudio mit nur einem Sprecher, halten Sie Ton und Darbietung konsistent, verwenden Sie denselben Klon wieder, speichern Sie die Generierungseinstellungen, standardisieren Sie die Skriptformatierung und vergleichen Sie neue Ausgaben mit einer genehmigten Referenz.
Soll ich eine lange Sprachausgabe oder viele kleine Clips generieren?
Verwenden Sie überschaubare Abschnitte. Sehr lange Generierungen können abweichen, während satzweise Generierung abgehackt klingen kann. Fassen Sie zusammenhängende Sätze in kurze logische Segmente zusammen, die leicht neu generiert und bearbeitet werden können.
Welche Einstellungen beeinflussen die Konsistenz der KI-Stimme?
Je nach Plattform können Stabilität, Ähnlichkeit, Stil, Geschwindigkeit, Tonhöhe, Emotion, Sprache und Modellauswahl die Darbietung beeinflussen. Speichern Sie ein genehmigtes Preset, anstatt die Einstellungen für jeden Clip unterschiedlich anzupassen.
Wie kann ich sicherstellen, dass Produktnamen in jedem Video gleich ausgesprochen werden?
Erstellen Sie ein Aussprache-Glossar und verwenden Sie in jedem Skript dieselbe Schreibweise oder phonetische Form. Testen Sie schwierige Namen einmal und machen Sie die genehmigte Form zum Bestandteil der Produktionsvorlage.
Kann eine KI-Stimme in verschiedenen Sprachen konsistent bleiben?
Die Stimmenidentität kann oft bis zu einem gewissen Grad beibehalten werden, aber Akzent und Aussprache können sich ändern. Entscheiden Sie, ob die Marke eine globale Stimmidentität oder eine natürlichere regionale Aussprache bevorzugt, und wenden Sie diese Strategie dann konsequent an.