
 ChatGPT
 Perplexity
 Gemini
 Claude
 Grok
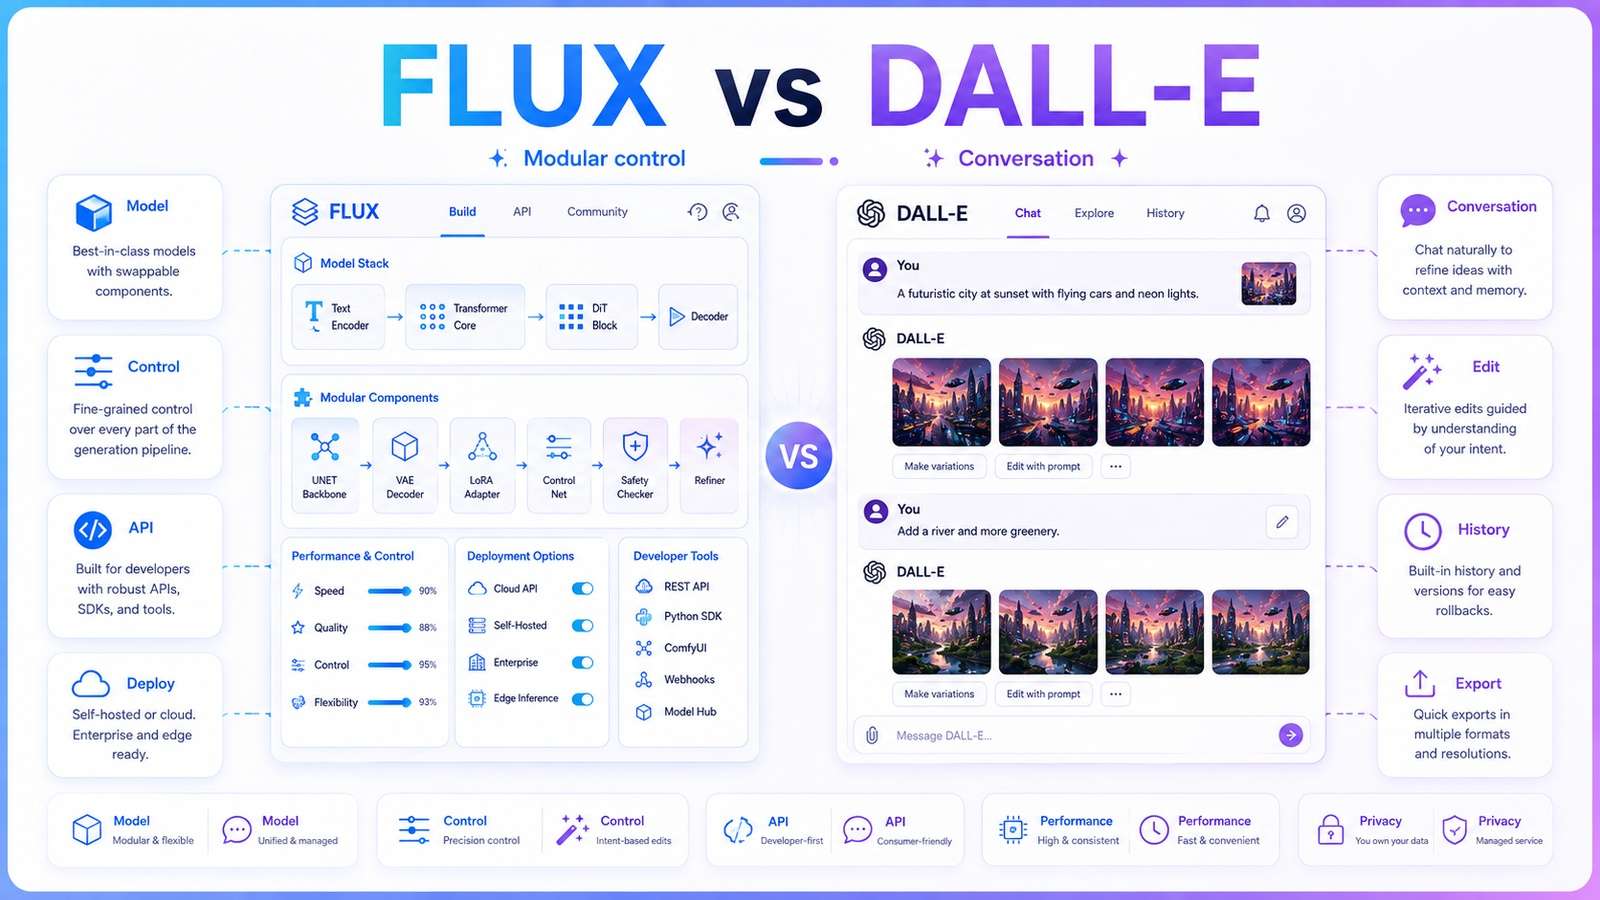
FLUX vs DALL-E doit être testé après la première image attrayante. En 2026, les modèles pertinents sont FLUX.2 et GPT-Image-2, et pas seulement FLUX.1 face à DALL-E 3. Les deux peuvent générer et modifier des images, suivre des instructions détaillées et gérer du texte. Leur différence devient plus claire lorsqu'un produit, une personne, une mise en page et une couleur de marque doivent survivre à plusieurs révisions.
Dans cet article
Comparer FLUX.2 avec GPT-Image-2, pas les anciennes mémoires de marque
Black Forest Labs recommande FLUX.2 pour les projets actuels de texte en image et d'édition. La famille comprend des options Pro et Max axées sur la qualité, Flex pour la typographie et les petits détails, ainsi que des variantes Klein conçues pour la vitesse et le déploiement sélectif en poids ouvert. FLUX.2 prend en charge l'édition multi-référence, les instructions de couleur exactes, les formats d'image flexibles et des sorties allant jusqu'à 4 MP sur les routes prises en charge.
Le modèle développeur actuel d'OpenAI est GPT-Image-2, tandis que les utilisateurs de ChatGPT interagissent avec ChatGPT Images 2.0. Il prend en charge la génération et l'édition d'images avec des entrées d'image haute fidélité et une interface conversationnelle dans ChatGPT. Le mot-clé DALL-E reste utile pour la recherche, mais les décisions de production doivent nommer le modèle et le point de terminaison actuels.
FLUX expose une famille de modèles ; OpenAI connecte les images à la conversation
| Capacité | FLUX.2 | GPT-Image-2 / ChatGPT Images |
|---|---|---|
| Édition multi-référence | Prise en charge explicite de la combinaison de plusieurs images d'entrée | Entrées d'image haute fidélité et édition conversationnelle |
| Contrôle exact des couleurs | Prend en charge les instructions telles que les couleurs HEX sur les flux de travail pertinents | Décrire la couleur cible et réviser de manière conversationnelle |
| Route typographique | La variante Flex se spécialise dans la typographie et les détails | La génération d'images OpenAI actuelle met l'accent sur un texte précis |
| Chemin en poids ouvert | Disponible pour certaines variantes Klein sous leurs licences | Aucun poids GPT-Image-2 téléchargeable |
| API | Points de terminaison officiels spécifiques au modèle | Points de terminaison de génération et d'édition d'images OpenAI |
| Flux de travail grand public | Accès via des fournisseurs et des applications | Conversation ChatGPT et éditeur d'images |
FLUX.2 peut être traité comme un composant sélectionné pour une tâche : qualité maximale, itération rapide, typographie ou contrôle local. OpenAI offre un modèle d'interaction plus unifié : discuter du brief, télécharger des références, générer et continuer à modifier la ressource en contexte. Les développeurs doivent toujours convertir cette logique créative en appels API reproductibles.
Exécuter un benchmark de campagne produit en trois rounds
Utilisez un vrai emballage ou appareil plutôt qu'un portrait générique. Préparez une référence produit propre, un recadrage de logo et d'étiquette, une palette, une référence d'arrière-plan et une esquisse de mise en page.
- Premier round - création : placer le produit dans une nouvelle scène avec une caméra, une surface, un éclairage et un espace de texte vide exacts.
- Deuxième round - adaptation : créer des variantes carrées et verticales tout en préservant l'échelle du produit, la géométrie, l'étiquette et le matériau.
- Troisième round - correction : changer un accessoire, une couleur HEX et une ligne de texte sans modifier quoi que ce soit d'autre.
Évaluer chaque round indépendamment. Un modèle peut gagner la création et perdre la correction. Enregistrer la dérive de la forme du produit, les mutations d'étiquettes, les changements de recadrage inattendus, les changements de visage ou de main, les décalages d'éclairage, les regenerations et le nombre de corrections manuelles nécessaires avant approbation.
Les contrôles multi-référence et de couleur de FLUX.2 sont directement pertinents pour la cohérence du produit. La force de GPT-Image-2 est l'interprétation d'une intention de révision en langage naturel complexe. Le résultat dépendra de la variante exacte, du niveau de qualité, des références et de la conception des invites - pas du nom de l'entreprise.
Rendre le troisième round intentionnellement difficile
Le premier round doit établir le produit approuvé et la direction artistique. Le deuxième round doit l'adapter à un nouveau canal et point de vue. Le troisième round doit demander une correction étroite après ces changements - par exemple, réparer une ligne de texte, remplacer un accessoire reflété dans le verre, ou changer la manche d'un modèle tout en gardant la pose et l'emballage fixes. Cela expose la dérive accumulée qu'un benchmark de première génération ne peut pas voir.
Évaluer chaque round pour la conformité aux invites, la géométrie du produit, l'identité de référence, la couleur exacte, le texte lisible, la zone de changement non intentionnelle, la latence et les minutes de réparation manuelle. Garder les sorties anonymes lors de la révision. Un modèle qui gagne le premier round mais perd la marque après le troisième round peut être idéal pour l'art conceptuel et inadapté à un pipeline de campagne automatisé.
La décision API est une décision d'architecture
Choisir le fournisseur seulement après avoir répondu à l'emplacement des fichiers, à la façon dont les invites sont versionnées, si les résultats sont interrogés ou diffusés en continu, comment les échecs sont retentés, quel alias de modèle est épinglé, et comment le coût et la modération sont surveillés. Un prototype qui fonctionne dans une interface web peut échouer en production parce que sa conversation cachée, son ordre de référence ou sa sélection manuelle n'ont jamais été capturés.
- Épingler les instantanés de modèles ou les points de terminaison stables lorsque disponibles.
- Stocker l'ordre d'entrée et le rôle de chaque image de référence.
- Versionner les invites et les contraintes négatives avec la ressource.
- Journaliser la latence, les nouvelles tentatives, les échecs de sécurité et les sorties rejetées.
- Conserver une étape d'approbation humaine pour les personnes, les marques, les affirmations et le texte d'emballage.
FLUX offre plusieurs points de terminaison et des routes auto-hébergeables sélectionnées, créant plus de choix d'architecture. OpenAI fournit une plateforme unique plus large avec des points de terminaison d'image actuels et ChatGPT comme interface interactive. Plus de choix améliore l'optimisation mais augmente la configuration et la maintenance.
Tenir un journal des échecs de deuxième édition
Concevoir pour le changement de point de terminaison avant le lancement
| Couche d'architecture | Choix de conception portable | Avertissement de verrouillage |
|---|---|---|
| Brief | Exigences structurées indépendantes de la syntaxe des invites | La logique métier vit dans une seule longue invite |
| Références | Stockage normalisé, consentement, recadrage et métadonnées de couleur | Les ressources sont préparées uniquement pour un point de terminaison |
| Génération | L'adaptateur mappe les champs partagés vers FLUX ou GPT Image | Les appels d'application sont dispersés dans la base de code |
| Évaluation | Tests d'acceptation neutres par rapport au modèle et révision humaine | Le succès est défini par l'esthétique d'un seul modèle |
| Audit | Le modèle, la version, les entrées, la sortie et les modifications sont journalisés | Les fichiers approuvés ne peuvent pas être tracés jusqu'à une demande |
La structure familiale de FLUX.2 rend le routage explicite des modèles attrayant : Flex pour les travaux à forte typographie, Max ou Pro pour la qualité, et certaines variantes Klein pour un déploiement contrôlé. GPT-Image-2 offre une route gérée plus simple à l'intérieur de la plateforme OpenAI. Dans les deux cas, un adaptateur et une couche d'évaluation neutre par rapport au modèle réduisent le coût de changement des points de terminaison lorsque la qualité, la politique, la latence ou le prix changent.
Créer un tableau pour chaque ressource de test avec le changement demandé, les éléments préservés, les changements non intentionnels, les regenerations, la latence, le coût et le temps de réparation manuelle. Le revoir après dix tâches. Cela évite qu'un premier rendu mémorable l'emporte sur des échecs de production répétés.
Pour les équipes qui n'ont pas besoin d'API de modèles directs ou de poids ouverts, Media.io Text to Image offre une création multi-modèle basée sur navigateur, et Image to Image prend en charge les transformations de référence. Il s'agit d'un flux de travail créateur plus court, pas un remplacement pour le contrôle au niveau des points de terminaison.
Séparer le benchmark créatif du benchmark système. Un responsable créatif doit évaluer les images anonymes pour la précision du brief, la hiérarchie, le texte lisible, la continuité du sujet et l'effort de réparation. Un ingénieur doit évaluer la latence, la gestion des échecs, les limites des images de référence, la taille de sortie, le comportement de modération, la journalisation et le travail nécessaire pour reproduire un résultat accepté. La combinaison de ces scores empêche que la préférence visuelle ou la commodité d'infrastructure décide seule.
Tester également la substitution de modèles. Exécuter la même demande via deux variantes FLUX.2 et via GPT-Image-2, puis remplacer un composant dans l'application. Si changer le modèle force des réécritures d'invites, des changements de pipeline de ressources ou de nouvelles règles de révision, ce coût de migration appartient à la décision. Une pile API apparemment flexible peut toujours créer un verrouillage par des invites, la préparation des références et les seuils d'acceptation.
Modéliser explicitement l'incertitude
Une estimation de production doit contenir des plages, pas un seul chiffre de vitrine. Mesurer la latence médiane et dans le pire des cas, les sorties acceptées par demande, les modifications supplémentaires par ressource acceptée, les échecs de modération ou de validation, et le pourcentage de tâches nécessitant un recours humain. Répéter la mesure pour la typographie, la fidélité du produit, les personnes et la composition multi-référence car un score agrégé peut masquer une classe d'échec critique.
Ensuite, créer des règles de routage. Une bannière à forte typographie pourrait utiliser un point de terminaison FLUX.2 spécialisé pour le texte ; un brief créatif ambigu peut aller vers un flux GPT Image conversationnel ; une tâche sensible ou à fort volume peut justifier un déploiement contrôlé. Le routage est plus réaliste que de déclarer un modèle gagnant universel, mais cela ne fonctionne que si les données d'évaluation et les journaux d'audit utilisent les mêmes définitions entre les points de terminaison.
Enfin, prévoir un budget pour la dérive du modèle actuel. Les fournisseurs hébergés améliorent et remplacent les systèmes, tandis que les déploiements en poids ouvert préservent un artefact choisi mais nécessitent une maintenance. Épingler ce qui peut être épinglé, conserver des briefs de test golden, et les réexécuter après tout changement de modèle, d'invite ou de prétraitement.
Savoir quand le routage multi-modèle est une sur-ingénierie
Une couche de routage a du sens lorsque le volume, le coût des échecs ou la diversité des tâches peut compenser le travail d'ingénierie. Elle est inutile pour une petite équipe produisant quelques images de campagne manuellement. Dans ce cas, le flux conversationnel géré de ChatGPT ou un seul point de terminaison FLUX hébergé peut apporter plus de valeur qu'une abstraction conçue pour une échelle hypothétique.
Rejeter la route FLUX si l'organisation ne peut pas maintenir le déploiement en poids ouvert sélectionné ou ne peut pas documenter la variante hébergée exacte derrière les ressources acceptées. Rejeter la route OpenAI si le flux de travail nécessite la garde du modèle, une limite de déploiement qu'elle ne peut pas fournir, ou un contrôle déterministe au niveau des composants. Ce sont des contraintes d'architecture, pas des plaintes sur la qualité des invites.
FAQ FLUX vs DALL-E
-
DALL-E est-il toujours le modèle d'image OpenAI actuel ?
Non. L'expérience grand public actuelle est ChatGPT Images, et le modèle développeur actuel inclut GPT-Image-2. DALL-E reste un mot-clé de comparaison courant. -
Quel modèle FLUX doit être comparé avec DALL-E ?
Commencez avec FLUX.2 Pro pour une comparaison hébergée générale, puis testez Max pour la qualité, Flex pour la typographie et les détails, ou Klein pour la vitesse et le déploiement open-weight éligible. -
Lequel est meilleur pour la cohérence des produits ?
FLUX.2 propose des flux de travail multi-références explicites et des contrôles de couleur, tandis que GPT-Image-2 offre de puissantes entrées d'images et des modifications guidées par instructions. Testez plusieurs révisions sur le même produit. -
FLUX peut-il fonctionner localement ?
Certaines variantes de FLUX.2 Klein disposent de routes open-weight conçues pour les GPU grand public. Les autres modèles FLUX sont accessibles dans le cadre de différentes conditions d'API ou de licence. -
Lequel est meilleur pour une API d'application ?
Les deux fournissent des API d'image actuelles. Choisissez après avoir testé la qualité requise, la gestion des références, la latence, la tarification, la politique, l'observabilité et le niveau de spécialisation des points de terminaison que votre équipe peut maintenir.