
 ChatGPT
 Perplexity
 Gemini
 Claude
 Grok
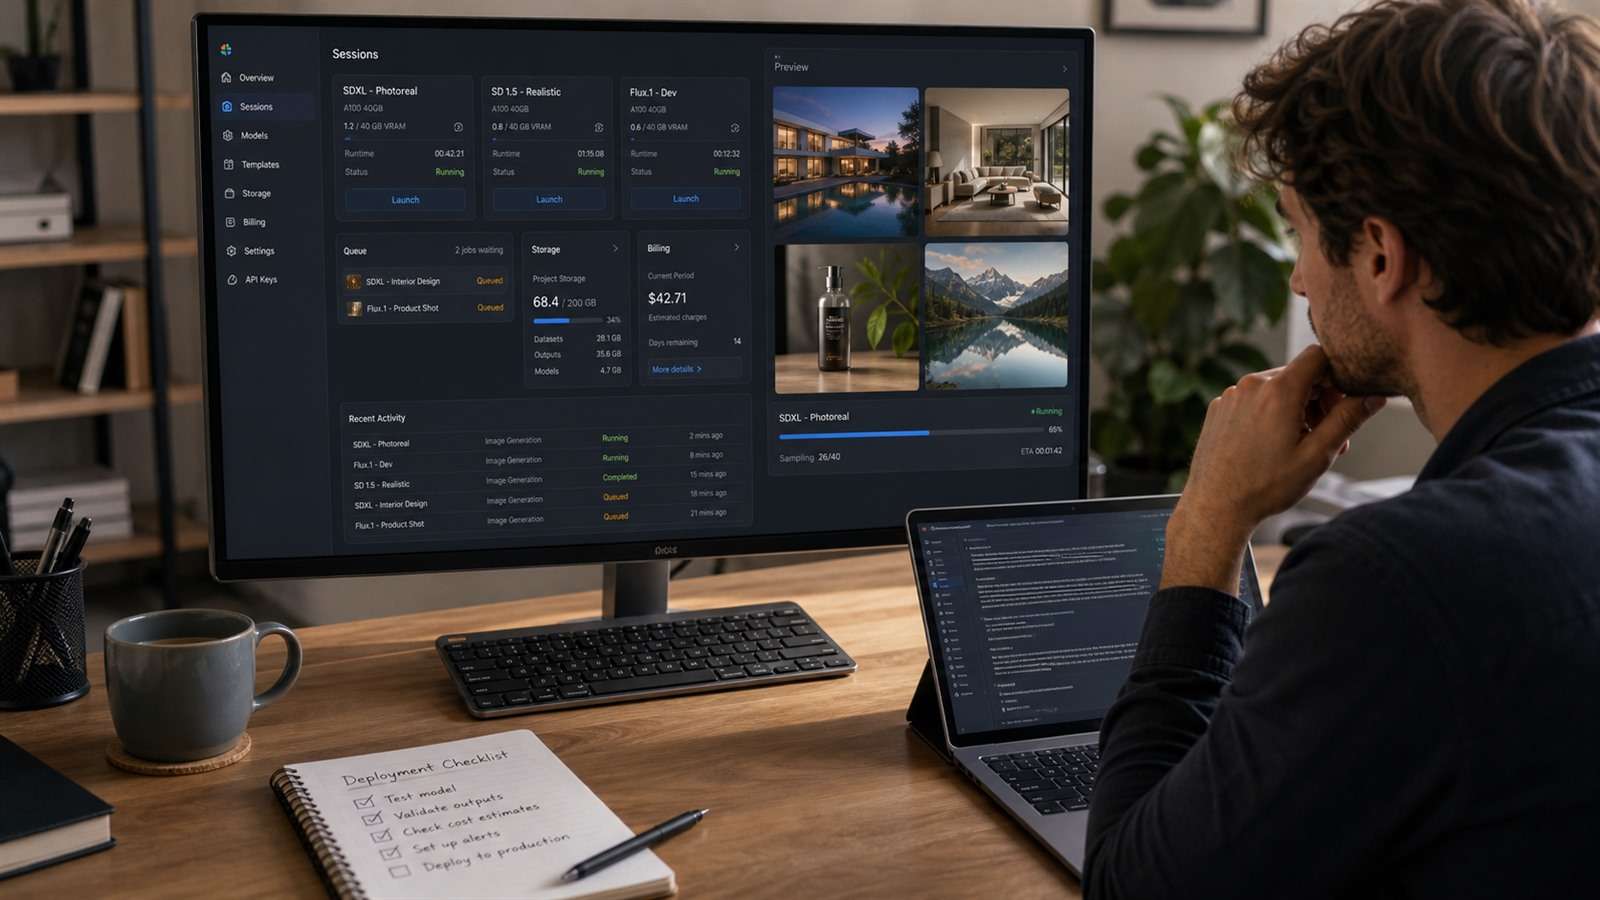
RunDiffusion a d'abord séduit les créateurs souhaitant accéder à Automatic1111, ComfyUI, Fooocus, des modèles et de la puissance GPU sans avoir à construire une station de travail. Sa plateforme actuelle couvre également des outils d'image et de vidéo multi-modèles, des tableaux, des équipes, une gouvernance et des plugins. Cette étendue signifie qu'une alternative à RunDiffusion peut être soit un studio créatif géré, soit une infrastructure louée brute — et la facturation se comporte de manière très différente.
Dans cet article
Le compteur tourne pendant que vous téléchargez des modèles, déboguez des nœuds et oubliez d'arrêter
Le prix horaire du GPU n'est qu'une composante du coût. Une estimation mensuelle réaliste est :
Temps de session GPU + stockage persistant + transfert réseau + abonnement à la plateforme + temps de configuration échoué + maintenance humaine
Une instance à 0,50 $ de l'heure peut être coûteuse si elle passe 25 minutes à reconstruire un environnement. Une machine gérée à 1,50 $ peut être économique si les modèles, les extensions et les sorties persistent et que le créateur commence à générer immédiatement. L'arrêt automatique, la détection d'inactivité, le temps de démarrage et l'accès aux fichiers lorsque le GPU est éteint méritent leurs propres lignes dans la comparaison.
Ajoutez la main-d'œuvre et la récupération après échec à l'estimation. Une instance brute peut être moins chère par heure GPU, mais plus coûteuse pour un designer qui passe du temps facturable à reconstruire des conteneurs, à réparer des chemins de modèles ou à expliquer une configuration non documentée à un coéquipier. Un service géré justifie sa prime uniquement lorsque ce temps économisé est mesurable.
Choisissez un studio géré ou une infrastructure — ne prétendez pas qu'ils sont identiques
| Voie | Exemples | Idéal pour | Charge opérationnelle |
|---|---|---|---|
| Studio de diffusion géré | ThinkDiffusion | Artistes souhaitant des interfaces préchargées et des fichiers créatifs persistants | Faible à moyen |
| Plateforme GPU en conteneur | RunPod | Utilisateurs techniques déployant des modèles, des pods et des API | Moyen |
| Place de marché GPU | Vast.ai | Utilisateurs sensibles aux coûts capables d'évaluer les hôtes et les instances | Élevée |
| Développement en notebook/cloud | Paperspace | Code, entraînement, expériences et travaux ML plus larges | Moyen à élevé |
| Flux de travail en nœuds hébergé | Comfy Cloud | Utilisateurs de ComfyUI évitant l'installation locale | Faible à moyen |
| Station de travail locale | ComfyUI, Invoke, Forge | Utilisation intensive répétée, confidentialité et propriété du flux de travail | Élevée au départ ; plus faible par session |
| Plateforme créative grand public | Media.io | Utilisateurs ayant besoin de résultats, pas d'une infrastructure de diffusion | Faible |
Sept alternatives à RunDiffusion
1. ThinkDiffusion — le laboratoire cloud géré le plus proche
ThinkDiffusion propose des machines cloud dédiées avec des interfaces créatives préchargées, des disques privés, des téléchargements de modèles, des extensions, des nœuds personnalisés et des options de stockage persistant. Sa formule Hobby à la demande et ses niveaux d'abonnement la rendent comparable au cas d'utilisation traditionnel de RunDiffusion.
Comparez la VRAM de la machine, le stockage de base, la fenêtre de persistance, l'accès aux fichiers lorsque la machine est arrêtée et les tarifs horaires réduits. La correspondance de fonctionnalités la plus proche n'est pas automatiquement la correspondance la moins chère pour votre modèle d'utilisation.
2. RunPod — modèles, pods et chemins sans serveur pour les équipes techniques
RunPod ressemble davantage à une infrastructure. Il convient aux utilisateurs capables de déployer un modèle, d'attacher un stockage, de gérer des ports et des conteneurs, et de décider si un pod interactif ou une charge de travail de style API est approprié. Il peut être flexible et rentable, mais le dépannage vous appartient.
3. Vast.ai — tarification sur place de marché pour les utilisateurs capables d'évaluer les risques
Vast.ai expose une place de marché d'hôtes GPU avec du matériel, une fiabilité, une bande passante, un stockage et des prix variables. Il est attrayant pour les utilisateurs expérimentés qui optimisent les coûts. C'est un mauvais choix pour quelqu'un qui souhaite une seule équipe de support et une expérience machine uniforme.
Filtrez au-delà du nom du GPU. La bande passante PCIe, la vitesse du disque, le transfert Internet, la vérification, le score de fiabilité et l'interruptibilité peuvent affecter une charge de travail de diffusion.
4. Paperspace — notebooks et travaux d'apprentissage automatique plus larges
Paperspace convient aux projets qui mêlent génération d'images avec des notebooks, du code, des ensembles de données et des expériences de modèles. C'est moins un studio artistique clé en main et davantage un environnement de développement. Choisissez-le si Stable Diffusion est l'une des charges de travail au sein d'un projet ML plus vaste.
5. Comfy Cloud — restez dans ComfyUI sans maintenir une installation locale
Comfy Cloud est l'alternative naturelle lorsque votre actif important est le graphe ComfyUI, et non un bureau hébergé spécifique. Il réduit la friction de l'installation locale tout en préservant le modèle mental basé sur les nœuds. Vérifiez la disponibilité des nœuds personnalisés, l'accès aux modèles, la rétention et la tarification par rapport aux flux de travail que vous exécutez réellement.
6. Une station de travail locale ComfyUI ou Invoke — propriété prévisible pour une utilisation intensive
Le matériel local transforme les dépenses cloud variables en un achat initial plus l'électricité, le stockage et la maintenance. Il est intéressant pour un travail fréquent avec de grands ensembles de données privées, un chargement répété de modèles ou des dépendances personnalisées. Il est moins attrayant si vous générez occasionnellement ou avez besoin de plus de VRAM que vous ne pouvez justifier d'acheter.
7. Media.io — évitez entièrement la décision d'infrastructure
Si vous n'avez pas besoin de points de contrôle, de nœuds personnalisés ou d'un bureau distant, une plateforme créative peut résoudre la tâche réelle avec beaucoup moins de configuration. Media.io Texte vers Image gère la création d'images dans le navigateur, et Image vers Image prend en charge les transformations de référence et les modifications de suivi.
Ce n'est pas un remplacement GPU cloud équivalent. C'est la meilleure réponse lorsque l'exigence est « produire des images de campagne et continuer à éditer » plutôt que « héberger ma propre pile de diffusion ».
Exécutez un benchmark de stockage et de démarrage avant de déplacer vos modèles
- Créez un compte ou un espace de travail vierge et démarrez un GPU cible.
- Mesurez le temps jusqu'à ce que l'interface soit utilisable.
- Installez un nœud personnalisé non par défaut et un modèle représentatif.
- Exécutez un flux de travail fixe et enregistrez le temps de génération et la VRAM maximale.
- Arrêtez la machine ; confirmez quel stockage continue à être facturé.
- Redémarrez après un jour et après la fenêtre de persistance gratuite.
- Téléchargez les résultats sans allumer un GPU coûteux, si pris en charge.
- Déclenchez l'arrêt automatique et confirmez qu'il se comporte comme prévu.
Testez également la récupération à partir d'un nœud ou d'un chemin de modèle cassé. La migration n'est pas réussie tant qu'un autre membre de l'équipe ne peut pas relancer le flux de travail à partir d'instructions écrites.
Répétez le benchmark après que l'espace de travail a été arrêté pendant une journée entière. Enregistrez ce qui survit : points de contrôle, LoRA, nœuds personnalisés, variables d'environnement, sorties et JSON de flux de travail. Certains services préservent un volume indépendamment du GPU ; d'autres facturent en continu ou traitent la machine comme jetable. Le comportement de récupération fait partie du produit.
Quand l'achat d'un GPU devient rationnel
Calculez le seuil de rentabilité avec le coût total de la station de travail divisé par les dépenses cloud mensuelles évitées, puis ajoutez l'électricité et la valeur de votre temps de maintenance. Le local l'emporte plus tôt lorsque vous générez quotidiennement, conservez des centaines de gigaoctets de modèles ou déplacez de grands ensembles de données privées. Le cloud l'emporte lorsque l'utilisation est par pics, que plusieurs tailles de GPU sont nécessaires ou que l'équipe ne peut pas maintenir les pilotes et les environnements.
FAQ sur la diffusion dans le cloud
-
Quelle est l'alternative la plus proche de RunDiffusion ?
ThinkDiffusion est la correspondance la plus proche pour un espace de travail cloud géré avec des interfaces Stable Diffusion populaires, un stockage privé, des modèles et des extensions. Comparez les tarifs actuels des machines et les règles de persistance. -
RunPod est-il moins cher que RunDiffusion ?
Il peut avoir des prix de calcul bruts plus bas, mais le coût total dépend du temps de configuration, du stockage, du transfert, des sessions inactives et de la maintenance. Comparez le coût par flux de travail complété, pas seulement le tarif GPU affiché. -
Puis-je déplacer un flux de travail ComfyUI entre les services ?
Généralement oui, mais le flux de travail peut dépendre de nœuds personnalisés, de chemins de modèles, de versions et d'API propriétaires. Exportez le JSON et enregistrez chaque dépendance. -
Que se passe-t-il avec les modèles lorsqu'une session cloud s'arrête ?
Cela dépend du stockage attaché et du plan. Certains services conservent un disque, d'autres facturent séparément, et d'autres suppriment les fichiers après une fenêtre d'inactivité. Vérifiez avant de télécharger une grande bibliothèque de modèles. -
Devrais-je utiliser du matériel local à la place ?
Le matériel local convient aux charges de travail fréquentes, privées et stables. Les services cloud conviennent aux pics occasionnels, aux besoins GPU changeants et aux utilisateurs qui ne souhaitent pas effectuer un achat de matériel initial.