Если рассказчик немного меняется каждый раз при смене сцены, зрители это замечают, даже если не могут объяснить почему.Последовательность голоса — это не только тембр. Темп, акцент, придыхание, эмоции, произношение, громкость и акустика помещения — всё это может заставить одного и того же синтетического диктора звучать как другой человек.
Curious Refuge сравнивает эти три рабочих процесса в специальном руководстве по согласованности голоса. Сначала посмотрите на контраст, а затем используйте остальную часть этого руководства, чтобы превратить предпочтительный голос в воспроизводимую серийную спецификацию с контролируемыми сценариями, настройками, многоязычной подачей, нормализацией и контролем качества.
В этой статье
- Определите, что означает «тот же голос» для вашего проекта
- Используйте тот же голосовой ресурс, а не похожий
- Начните с чистого и последовательного эталонного аудио
- Зафиксируйте настройки голоса для всей серии
- Стандартизируйте сценарий перед генерацией аудио
- Генерируйте управляемыми сегментами
- Сохраняйте эмоциональный диапазон осознанным
- Тщательно согласовывайте голос в разных языках
- Нормализуйте готовое аудио, а не только настройки генератора
- Используйте эталонный аудиофрагмент при контроле качества
- Создайте воспроизводимый голосовой рабочий процесс в Media.io
- Контрольный список согласованности голоса ИИ
- Держите версии модели и рабочего процесса под контролем
- Часто задаваемые вопросы о согласованности голоса ИИ
Определите, что означает «тот же голос» для вашего проекта
Идентичность голоса — лишь одна из составляющих согласованности. Два фрагмента могут использовать один и тот же синтетический голос и всё равно звучать как разные произведения.
Определите цель в нескольких измерениях:
| Параметр согласованности | Что фиксировать |
| Голосовая идентичность | тембр, акцент, предполагаемый возраст и основной характер. |
| Подача | спокойная, энергичная, разговорная, авторитетная или игривая. |
| Темп | приблизительное количество слов в минуту и стиль пауз. |
| Эмоции | нейтральный базовый уровень и допустимый эмоциональный диапазон. |
| Характер записи | сухая студия, тёплая кабина, микрофон крупным планом или другой последовательный звук. |
| Громкость | целевой уровень для финального экспорта. |
| Произношение | имена, аббревиатуры, продукты, места и технические термины. |
Запишите всё это в голосовую спецификацию. Полезная спецификация может звучать так: «Тёплый женский голос диктора, чёткий нейтральный американский английский, средний темп, уверенный, но не навязчивый, короткие паузы между предложениями, без утрированного придыхания, звук сухой студии, последовательное произношение названий продуктов.»
Голосовая спецификация становится эталоном для каждого сценария и каждого этапа контроля качества.
Используйте тот же голосовой ресурс, а не похожий
Если платформа предоставляет идентификатор голоса, сохранённый голос или клонированный голос, повторно используйте тот же самый ресурс во всей серии. Не выбирайте новый голос только потому, что его предварительное прослушивание звучит похоже.
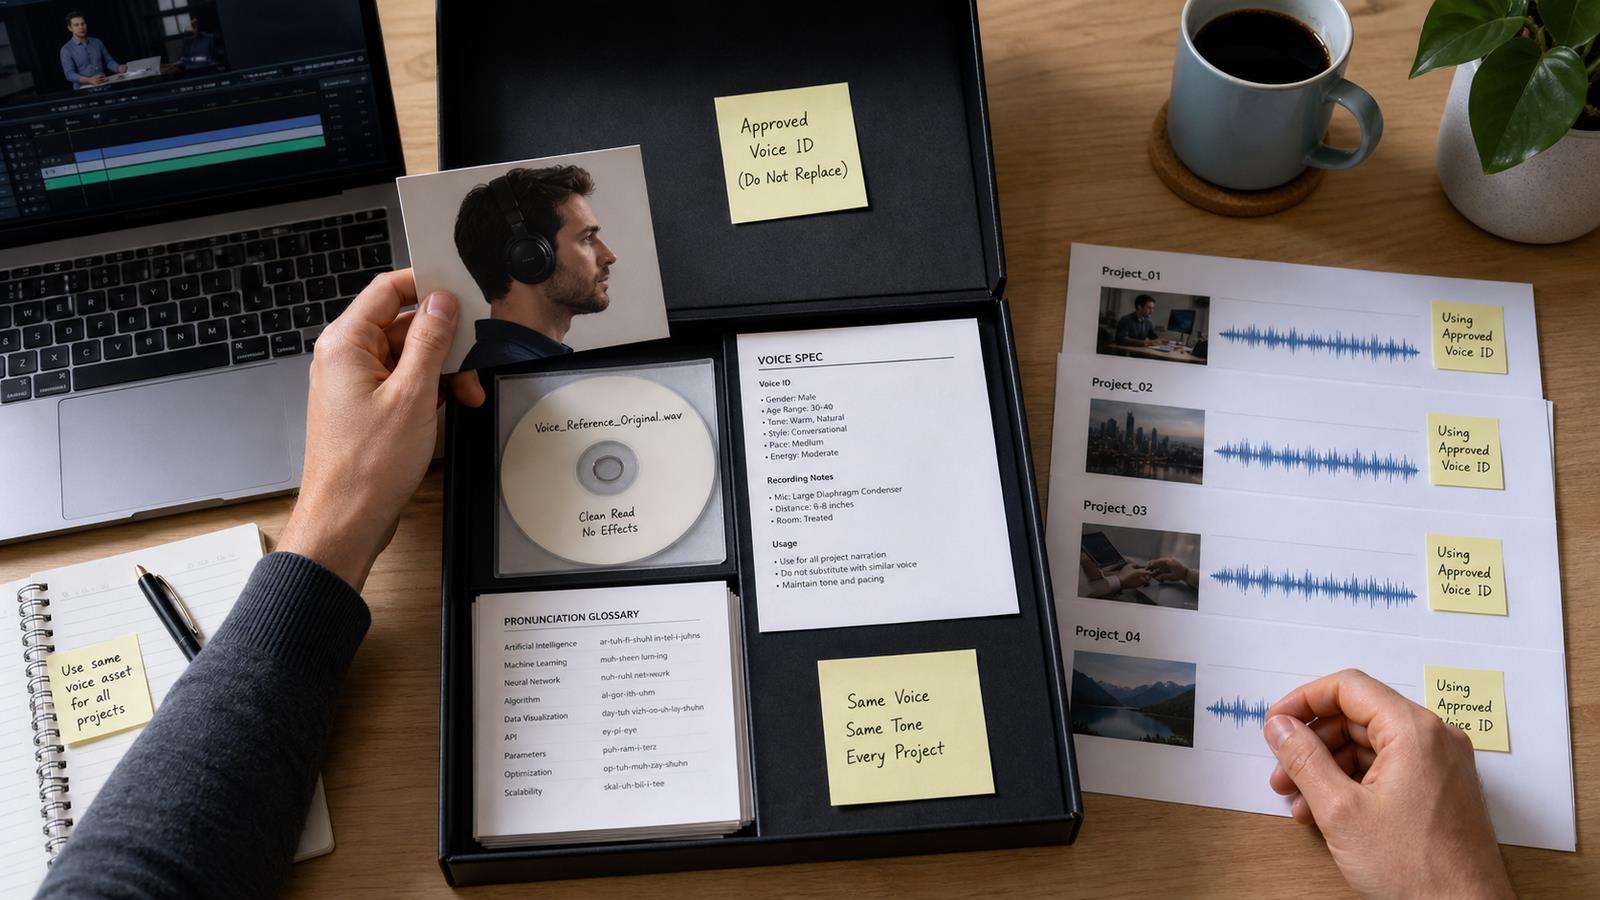
Для клонированных голосов сохраняйте оригинальные исходные записи. ElevenLabs отмечает, что воссоздание клона из тех же образцов всё равно может дать немного другой клон. Это ещё одна причина сохранять одобренный голосовой ресурс вместо того, чтобы воссоздавать его позднее.
Функция клонирования голоса с помощью ИИ в Media.io может использоваться для создания многоразового голоса для дикторского текста, маркетинга, обучения или озвучивания видео. Когда важна согласованность, рассматривайте одобренный клон как именованный производственный ресурс и фиксируйте, в каких проектах он используется.
Начните с чистого и последовательного эталонного аудио
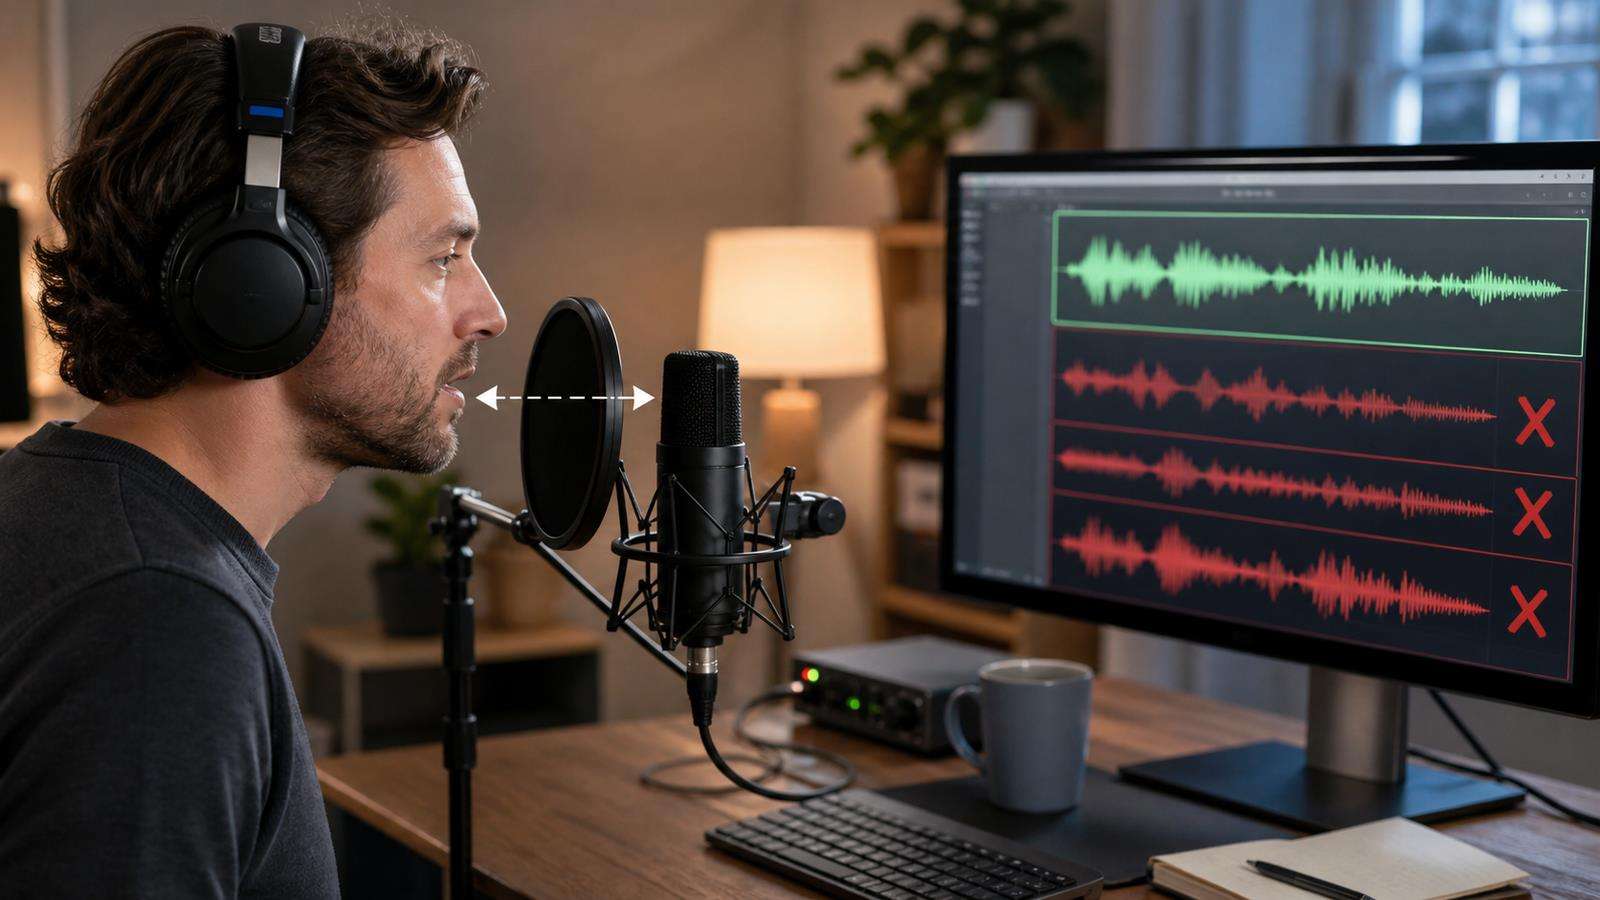
Клон учится на том, что слышит. Фоновый шум, реверберация помещения, смена микрофонов, большие перепады громкости и смешанные стили исполнения могут сделать генерируемый голос менее предсказуемым.
ElevenLabs рекомендует чистые записи одного диктора с постоянной громкостью, тоном, качеством звука и исполнением. Для своего рабочего процесса мгновенного клонирования голоса он рекомендует примерно одну-две минуты качественного аудио. Профессиональное клонирование требует значительно большего материала, но важный принцип остаётся тем же: качество и последовательность важнее, чем случайные минуты речи.
Записывайте именно тот голос, который хотите воспроизвести. Если цель — спокойный корпоративный диктор, не смешивайте в одном эталонном наборе шёпот, крик, актёрскую игру и случайные телефонные записи. Если вам нужны несколько эмоциональных режимов, управляйте ими осознанно, а не позволяйте обучающим данным превратиться в случайную смесь.
Зафиксируйте настройки голоса для всей серии
Многие системы TTS предоставляют элементы управления, влияющие на согласованность. Названия различаются в зависимости от платформы, но распространённые элементы управления включают стабильность, сходство, стиль, скорость, тон, эмоции и язык.
Записывайте настройки, использованные для одобренного фрагмента. Если вы меняете стабильность или стиль от одного видео к другому, вы намеренно изменяете поведение голоса.
ElevenLabs описывает стабильность как управление тем, насколько точно результат соответствует эталону и насколько случайность проявляется между генерациями. Он также предупреждает, что более сильное стилевое преувеличение может снизить стабильность. Это полезный общий урок: настройки, предназначенные для выразительности, могут сделать серию менее однородной.
Для производства установите один базовый пресет. Создавайте отдельные именованные пресеты только тогда, когда контент действительно требует их, например Narrator_Neutral, Narrator_Excited и Narrator_Soft. Не регулируйте ползунки на ощупь для каждого фрагмента.
Функция преобразования текста в речь в Media.io также позволяет выбирать голос, язык, скорость и тон. Фиксируйте эти настройки, когда серия видео должна иметь один стиль дикторского текста.
Стандартизируйте сценарий перед генерацией аудио
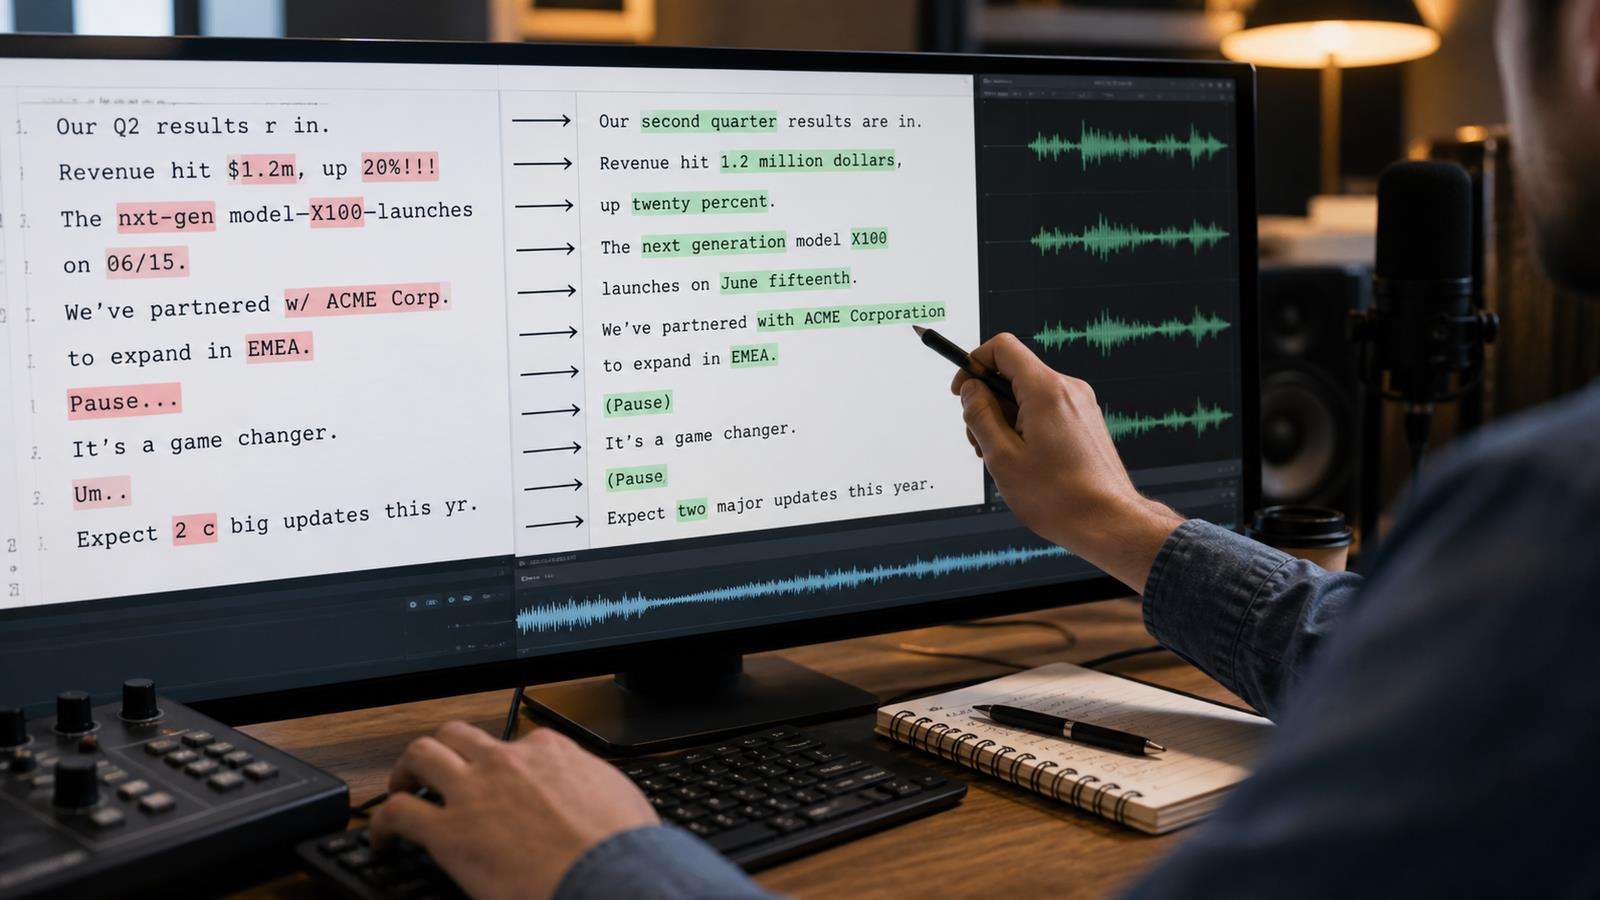
Вариации голоса могут быть обусловлены форматированием текста, а не только моделью голоса.
Создайте правила сценария для:
- Длины предложений.
- Стиля пунктуации.
- Чисел и дат.
- Аббревиатур.
- Названий продуктов.
- URL-адресов.
- Пауз.
- Ударений.
- Иностранных слов.
Если в одном сценарии написано «2026», а в другом — «две тысячи двадцать шесть», произношение может различаться. Если в одном используется «ИИ», а в другом — «И.И.», каденция может измениться. Если одно и то же название продукта иногда пишется через дефис, а иногда нет, модель может произносить его по-разному.
Составьте глоссарий произношения. Записывайте сложные термины фонетически, когда система это поддерживает, или используйте устойчивую текстовую форму, которую вы уже проверили.
Генерируйте управляемыми сегментами
При длинных генерациях может наблюдаться дрейф энергии, громкости, темпа или произношения. Разбивка сценария на более мелкие логические сегменты упрощает повторную генерацию только слабой строки и её сравнение с эталоном.
Руководство по устранению неполадок ElevenLabs специально рекомендует разбивать текст на более мелкие сегменты, когда громкость или качество меняются при длинных генерациях. Сегмент может представлять собой один абзац, одну сцену или от 10 до 30 секунд дикторского текста в зависимости от инструмента и контента.
Не делайте каждое предложение отдельным файлом, если только исполнение не становится слишком отрывистым. Группируйте предложения, относящиеся к одной мысли, чтобы просодия могла течь естественно. Оставляйте монтажные ручки в начале и конце для тайминга.
Называйте файлы систематически, например:
EP04_S03_VO_01.wav
EP04_S03_VO_02.wav
Это позволяет легко отследить строку в сценарии и повторно сгенерировать только необходимый сегмент.
Сохраняйте эмоциональный диапазон осознанным
Согласованность не означает монотонную подачу. Диктор может звучать более взволнованно при раскрытии информации и спокойнее при объяснении, оставаясь при этом тем же голосом. Ключевым является определение диапазона.
Создайте небольшую эмоциональную карту для серии:
- Зацепка: энергичные, короткие фразы.
- Объяснение: нейтральное и чёткое.
- Предупреждение: более медленное и серьёзное.
- Призыв к действию: тёплый, уверенный, без крика.
Если в одном фрагменте внезапно используется театральная подача, которой нет больше нигде, это будет звучать как другой диктор. Сохраняйте эмоциональный стиль, связанный с базовым голосом.
Когда система предлагает высоко выразительные элементы управления, генерируйте несколько вариантов и выбирайте тот, который наиболее близок к вашему одобренному эталону. Не предполагайте, что самый драматичный вариант является лучшим.
Тщательно согласовывайте голос в разных языках
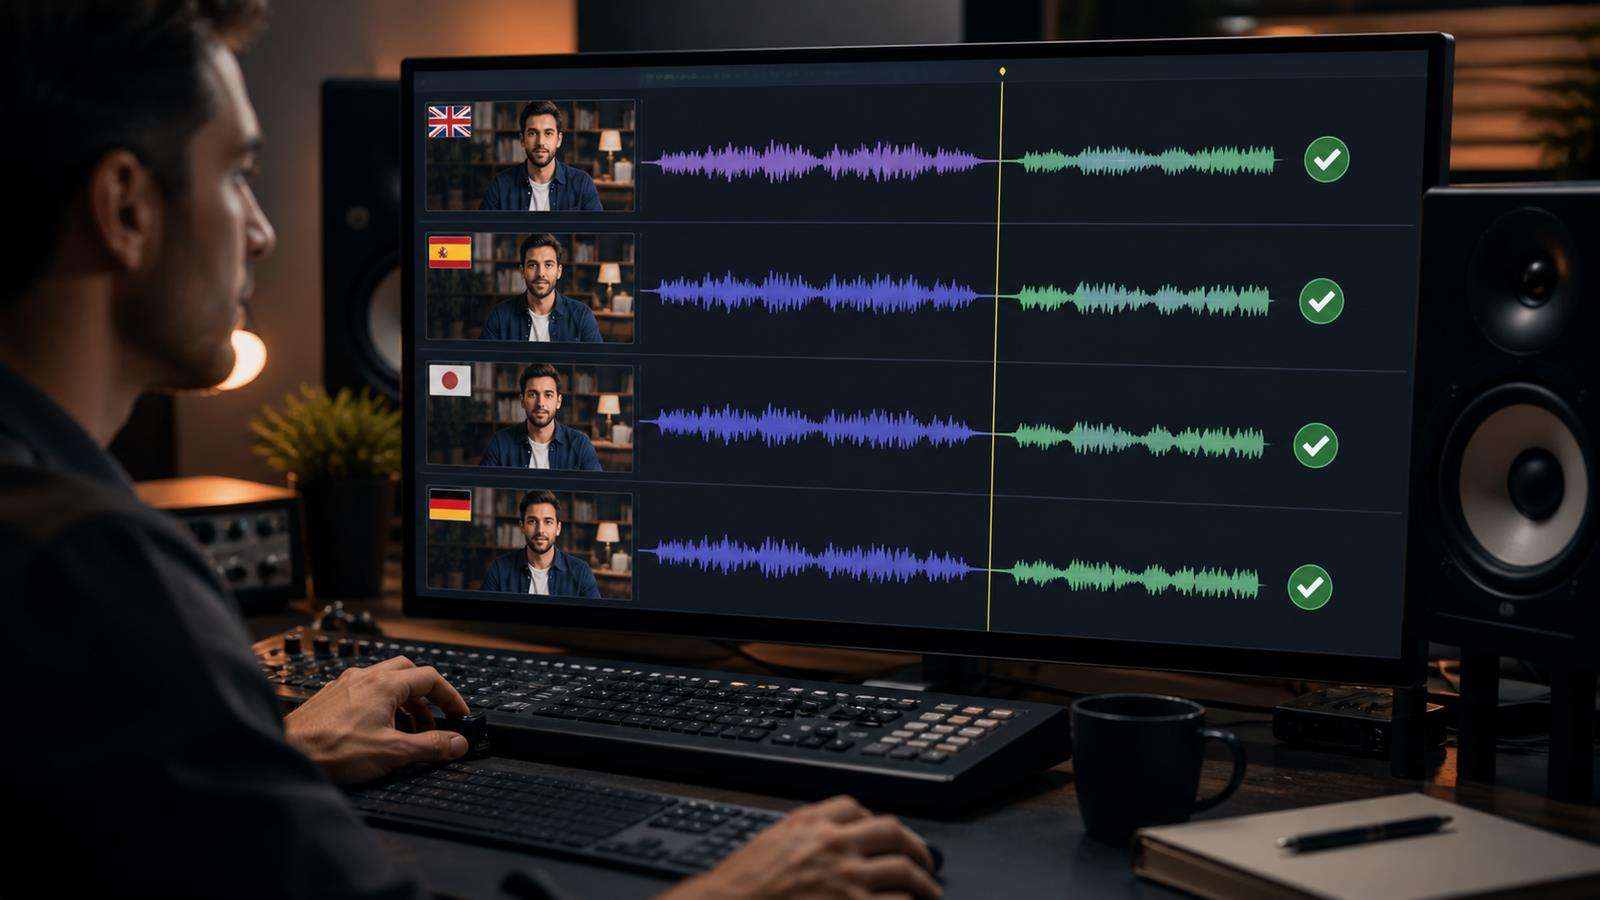
Многоязычное производство вносит ещё один уровень сложности. Клонированный английский голос, говорящий по-испански или по-японски, может сохранять некоторую идентичность, но менять акцент, ритм или произношение. ElevenLabs отмечает, что клонированные голоса могут сохранять акцент языка, использованного в исходных записях, при разговоре на другом языке.
Решите, что означает согласованность для разных рынков. Вы можете отдавать приоритет единой глобальной голосовой идентичности или отдавать предпочтение естественной местной подаче с голосами на целевых языках. Обе стратегии являются допустимыми брендовыми стратегиями.
Для существующего говорящего видео функция синхронизации губ с помощью ИИ в Media.io может синхронизировать заменяемое аудио с видимым диктором. Для статичного ведущего говорящий аватар с ИИ может создавать речь из изображения, сценария или аудио.
Нормализуйте готовое аудио, а не только настройки генератора
Два клипа могут использовать одинаковые настройки TTS и при этом иметь разную воспринимаемую громкость после редактирования. Фоновая музыка, компрессия, шумоподавление и настройки экспорта видео влияют на итоговый звук.
Создайте пресет финальной обработки звука для серии. Как минимум, проверьте:
- Громкость.
- Пиковый уровень.
- Уровень шумового порога.
- Эквализацию.
- Компрессию.
- Де-эссинг при необходимости.
- Тон помещения или атмосферный звук.
- Уровень музыки под дикторским текстом.
Применяйте одинаковую цепочку финальной обработки, если нет особых причин для отклонения. Если некоторые исходные референсы содержат шум, очистите их перед клонированием. AI Noise Reducer от Media.io может помочь в очистке, когда нежелательный фоновый звук присутствует в исходном или финальном голосовом треке.
Используйте эталонный аудиофрагмент при контроле качества
Не полагайтесь на память. Держите один короткий одобренный голосовой референс рядом при каждой сессии проверки. Воспроизведите референс, затем воспроизведите новый клип.
Сравните:
- Акцент и тембр.
- Темп.
- Эмоциональную энергию.
- Произношение.
- Придыхание.
- Громкость.
- Характер помещения или обработки.
Сравнение бок о бок делает небольшое отклонение гораздо легче различимым на слух. Для большой серии создайте контрольную нарезку из одного предложения каждого эпизода. Прослушивание образцов подряд выявляет постепенные изменения, которые могут быть незаметны при изолированном утверждении.
Создайте воспроизводимый голосовой рабочий процесс в Media.io
Для стабильного диктора создайте или выберите голос один раз, затем поддерживайте последовательность настроек и сценарных соглашений. Генерируйте закадровый голос управляемыми фрагментами, проверяйте его по утверждённому референсу и помещайте финальный звук в рабочий процесс видеомонтажа.
Если вам нужен многократно используемый клон, начните с Media.io AI Voice Cloning. Если вам нужен готовый голос с управлением скоростью и высотой тона, используйте преобразования текста в речь. Если финальное видео уже содержит говорящее лицо, используйте Lip Sync после того, как локализованный или скорректированный звук утверждён.
Контрольный список согласованности голоса ИИ
Перед публикацией серии клипов убедитесь в следующем:
- На протяжении всей серии используется один и тот же утверждённый голос или клон.
- Референсный звук чистый и однородный.
- Настройки голоса сохранены и не изменялись без документирования.
- Форматирование сценария соответствует единому стандарту.
- Названия продуктов и сложные термины соответствуют глоссарию произношения.
- Длинные сценарии разделены на управляемые сегменты.
- Эмоциональная подача остаётся в рамках утверждённого диапазона.
- Финальный звук использует единый подход к громкости и обработке.
- Каждый новый клип сравнивается с референсным образцом.
- Многоязычные версии следуют продуманной стратегии баланса между единой идентичностью и региональным акцентом.
Последовательный голос AI создаётся не одной идеальной настройкой. Это результат воспроизводимого процесса, который контролирует ввод, генерацию, сценарий, исполнение и постобработку.
Держите версии модели и рабочего процесса под контролем
Голос может меняться даже при неизменном сценарии и настройках, если изменяется базовая модель синтеза речи. Инструменты производства совершенствуются со временем, и новая модель может по-другому обрабатывать эмоции, паузы, произношение или клонирование. Фиксируйте версию модели или рабочего процесса, используемую для утверждённой серии, если платформа предоставляет такую информацию.
Перед переводом долгосрочного канала на новую модель сгенерируйте короткий тестовый сценарий с использованием старой и новой конфигурации. Включите названия продуктов, числа, эмоциональный диапазон и речевые конструкции, которые часто встречаются в серии. Сравните обе версии с утверждённым референсным голосом перед переключением всего процесса.
Если новая модель лучше, но заметно отличается на слух, относитесь к изменению как к решению о ребрендинге. Либо обновите всю серию, начиная с запланированной точки, либо сохраните старый рабочий процесс для существующего контента до тех пор, пока не станет возможным плавный переход. Незаметные изменения модели — одна из причин, по которой диктор может казаться изменившимся со временем, даже если никто намеренно не менял голос.
Часто задаваемые вопросы о согласованности голоса ИИ
Почему один и тот же голос AI звучит по-разному в разных клипах?
Генерация речи AI не является полностью детерминированной. Различия в референсном звуке, тексте, пунктуации, настройках, эмоциональном направлении, длине сегмента и постобработке — всё это может изменить результат.
Как сохранить последовательность клонированного голоса?
Используйте чистый референсный звук с одним диктором, поддерживайте однородность тона и исполнения, повторно используйте тот же клон, сохраняйте настройки генерации, стандартизируйте форматирование сценария и сравнивайте новые результаты с утверждённым референсом.
Следует ли генерировать один длинный текст или много коротких клипов?
Используйте управляемые фрагменты. Очень длинные генерации могут давать отклонения, тогда как генерация предложение за предложением может звучать несвязно. Группируйте связанные предложения в короткие логические сегменты, которые легко перегенерировать и отредактировать.
Какие настройки влияют на последовательность голоса AI?
В зависимости от платформы, стабильность, сходство, стиль, скорость, высота тона, эмоции, язык и выбор модели — всё это может влиять на подачу. Сохраняйте утверждённый пресет вместо того, чтобы по-разному настраивать параметры для каждого клипа.
Как обеспечить одинаковое произношение названий продуктов в каждом видео?
Создайте глоссарий произношения и используйте одно и то же написание или фонетическую форму в каждом сценарии. Протестируйте сложные названия один раз и включите утверждённую форму в шаблон производства.
Может ли один голос AI оставаться последовательным на разных языках?
Идентичность голоса зачастую может быть сохранена в определённой мере, однако акцент и произношение могут меняться. Определите, ценит ли бренд единую глобальную голосовую идентичность или более естественную региональную подачу, а затем последовательно придерживайтесь выбранной стратегии.