以自然語言指揮複雜的多模態任務
在12個混合檔案中組合最多9張圖像、3段影片與3段音訊,然後在一條指令中說明各自的角色——例如,同時參照一個鏡頭運動、一張角色圖像,以及一段聲音或歌曲。
 Seedance 2.5
需要的不只是一段無聲的文字轉影片片段嗎?Media.io 將 MiniMax H3 整合進以瀏覽器為基礎的單一工作流程,讓文字、圖片、影片與音訊能夠共同作為創作素材協同運作。直接控制角色、動作、鏡頭、風格、配音與節奏,然後生成最高 2K 畫質、長達 15 秒並附有原生立體聲音訊的影片.
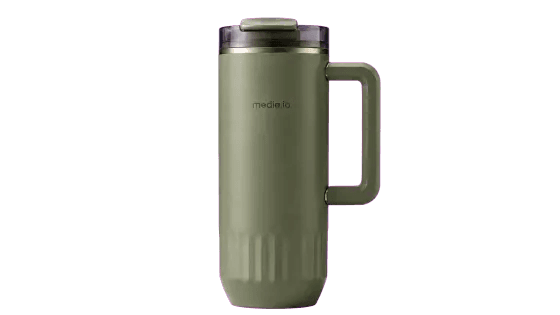
以上傳的圖片作為產品外觀的唯一參考,製作一段 15 秒、16:9 橫幅版本的高端產品官方網站登陸頁面 UI/UX 展示影片。核心產品為圖中所示帶有把手及保溫功能的軍綠色杯子。全程嚴格保持杯身顏色、圓柱比例、透明杯蓋、頂部開口結構、右側方形把手、金屬裝飾環及「media.io」標誌,不得改變產品形狀或創造其他杯型。
整體設計採用深色戶外功能風格,以及高端運動品牌官網的視覺風格:純黑背景,交織深色碳纖維、金屬拉絲與防水織物紋理,並融入快速流動的軍綠色與暖金色動態光帶。運用粗獷有力、略帶傾斜的超大無襯線字體,文字與產品形成前後遮擋的背景圖形關係。頁面排版精緻、克制,充滿速度感與力量感。
0 - 4 秒:從產品官網主畫面開始。保溫杯以極大比例懸浮於畫面中央,清晰易讀的巨型標題「BUILT TO GO」出現於背景中。產品緩慢靠近並輕微旋轉。綠色與金色光線迅速掃過杯身,突顯啞光材質、透明杯蓋、金屬環與寬大把手。頂部保留極簡導覽列,底部排列少量產品參數與縮圖。
4 - 6 秒:滑鼠向下滾動網頁,第一屏順暢向上退出。鏡頭隨頁面進入產品細節區域。杯蓋、把手、杯身與底部細節依序以橫向卡片呈現。滾動具有自然慣性與輕微速度模糊,但產品資訊保持清晰。
6 - 10 秒:進入產品功能區段。頁面左側顯示清晰標題「ALL-DAY TEMPERATURE」,右側展示完整懸浮保溫杯。產品以四分之一圈的角度緩慢穩定地旋轉。背景出現抽象冷氣流、細小水珠與金屬波紋,展現保溫與保冷性能。當滑鼠懸停於功能按鈕時,產品略微放大,背景從黑色變為淺灰色,文字與按鈕顏色同步反轉;僅改變 UI 背景與介面顏色,不改變保溫杯本身。
10—12 秒:繼續滾動至「LEAKPROOF LID」與「EASY-GRIP HANDLE」功能區。使用杯蓋與把手的特寫鏡頭,以幾何線條指向結構細節。頁面元素依序快速滑入並平穩停止。
12-15 秒:網頁順暢回到主畫面,保溫杯重新置於畫面中央並調整為適當大小,巨型標題「BUILT TO GO」位於產品後方。底部出現清晰的「ADD TO CART」膠囊按鈕。滑鼠精準移至按鈕中央並觸發懸停效果:按鈕放大、轉為黑白並散發綠色光暈;產品保持穩定。最終停留於完整的產品主視覺與購買按鈕畫面。
鏡頭與動畫:網頁平滑垂直滾動、產品懸浮旋轉、緩慢推進、圖層視差效果、高速光帶掃過、卡片滑入、滑鼠懸停放大、UI 色彩反轉。所有動作緊湊流暢,呈現真實且具互動感的高端產品網站展示效果。
限制:保溫杯的顏色、結構、把手位置、杯蓋形狀與品牌標誌不得更改;產品不得變形為其他杯型;不允許出現人物或手部;禁止開箱;杯子不得軟化、彎曲、融化或變形;不允許出現亂碼、錯誤標籤或多餘產品;色彩反轉僅影響網頁背景、按鈕與文字;產品必須始終保持清晰、完整與穩定。
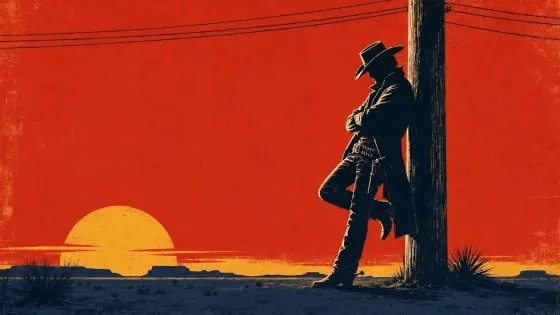
以附件參考圖作為精確的開場畫面與角色參考,
節奏——最高優先級:
將整段影片剪輯成充滿活力的150 BPM爵士西部節奏,搭配快速小鼓擊打、雙踩鼓脈衝、銳利銅管刺音、拍手聲、馬刺聲、鞭打聲與短促的左輪手槍轉輪喀噠聲。每一次剪切、姿勢、鏡頭移動、圖形條與字體擊打都必須精確落在正拍或半拍上。
在15秒內創造至少20至24個明顯不同的鏡頭。大多數鏡頭僅持續0.2至0.7秒。任何鏡頭的視覺畫面不得維持超過0.8秒不變。保持持續的視覺推進與不斷升級的能量。
僅使用極短的2至4幀微凍結,約0.08至0.15秒,並立即接續爆炸性動作。絕不將凍結幀保持整整一拍或數秒。節奏必須呈現如下感受:爆發——擊停——爆發——硬切——爆發。
視覺風格:
打造一個高能量的1960年代義大利式西部片片頭序列,融合世紀中期平面設計、Saul Bass風格構圖、包浩斯幾何、西部通俗海報、漫畫格框與粗糙絹印紋理。
將牛仔與環境細節渲染為大膽、高對比度的黑色剪影。僅使用飽和紅色、芥末黃、深海軍藍、黑色與少量奶油色高光。每次剪切都應引入新的色彩排列、裁切方式、圖形形狀或攝影機角度。
使用戲劇性斜角構圖、超大太陽圓圈、銳利的水平沙漠線條、快速移動的電報線、旋轉的左輪槍轉輪、靴子與馬刺特寫、風衣剪影、帽緣特寫、分割畫面、幾何快門、擴展圓圈、斜角條紋與粗體字體。
時間軸與鏡頭密度:
0.0—1.5秒 — 快速開場:
從精確的參考圖開始,僅持續0.2秒。
立即執行四次快速剪切:
寬景牛仔剪影映於紅色天空 → 快速縮放至帽緣 → 電報線橫掃畫面 → 陰影眼部極端特寫。
在選定鏡頭之間插入3幀黑色閃光。
牛仔在第一個主要銅管擊打時猛力推離電線桿。
1.5—4.0秒 — 細節衝擊蒙太奇:
創造六個快速特寫,每個持續約0.3至0.5秒:
靴子踏地 → 馬刺旋轉 → 風衣擺動 → 手指在槍套旁彎曲 → 皮帶扣閃光 → 左輪槍轉輪旋轉。
每次剪切時交替使用紅色、芥末黃與深海軍藍背景。
使用快速縮放、鞭搖、強力縮出、斜角擦除與2至4幀姿勢凍結。
4.0—7.0秒 — 加速行走:
展示牛仔快速穿越平坦芥末黃沙漠的畫面。
在全身側面視角、低角度靴子、俯視圖形剪影、揮動手部極端特寫與漫畫分割格框之間進行剪切。
他的行走節奏必須精確落在打擊樂上。
電報桿與沙漠線條朝反方向飛速掠過,以創造強烈的視差與速度感。
不得展示連續的緩慢行走——將動作分解成快速的節奏性片段。
7.0—10.0秒 — 幾何動作爆發:
將畫面分割為二、三,再分為四個漫畫格框。
在不同格框中展示帽子轉動、靴子停步、風衣展開、手靠近左輪槍,以及牛仔猛然看向鏡頭。
格框隨連續節拍猛然開合。
使用交替的全幀紅色、黃色、海軍藍與黑色閃光。
加入快速水平條紋、擴展太陽圓圈、旋轉星形與角狀陰影擦除。
每個構圖在0.5秒內切換。
10.0—13.0秒 — 高潮蓄積:
進一步加快剪輯速度,進行8至10次剪切:
眼睛 → 手 → 槍套 → 馬刺 → 左輪槍握把 → 風衣 → 電報線 → 超大太陽 → 牛仔全身剪影。
使用逐漸收緊的特寫與更強烈的快速縮放。
牛仔伸手拿槍,猛然轉身,擺出有力的槍手姿勢。
使用3幀完全停止,然後立即切換至下一個角度。
無慢動作,無冗長的懸疑停頓。
13.0—15.0秒 — 最終衝擊:
使用三次快速假結尾:
牛仔剪影映於黃色背景 → 硬切至海軍藍極端特寫 → 硬切至紅色寬景鏡頭。
在最後的音樂擊打上,揭示牛仔站於電線桿旁,背景為純紅色天空與超大芥末黃太陽。
精確標題「OUTLAW」以大型奶油色幾何字母猛然出現在畫面左側空白處。
最終構圖僅保持最後0.6秒,然後以立即的硬停作結。
MiniMax H3是一款通用全模態生成模型,專為將文字、圖像、影片與音訊整合為單一創意情境而構建。
描述這些輸入之間的關聯,H3即可依照指示生成或編輯具有原生立體聲的可控影片。
在12個混合檔案中組合最多9張圖像、3段影片與3段音訊,然後在一條指令中說明各自的角色——例如,同時參照一個鏡頭運動、一張角色圖像,以及一段聲音或歌曲。
使用 H3 以原始多模態情境再次處理,以 2K 解析度生成更清晰的產品、活動與社群媒體視覺素材,比單純傳統放大更能保留細小文字與精緻細節。
生成最長 15 秒的片段,以建立場景、發展動作,並以清晰的結尾收尾。
將詳細的創意簡報轉化為更可控的品牌、產品、廣告、剪輯與多鏡頭影片成果,並改善對文字與品牌資訊的處理能力。
參考現有影片來引導肢體動作、鏡頭行為、表演風格或剪輯節奏,同時將創意結構應用至新的主體或場景。
根據您需要固定不變的元素以及希望模型自由發揮的部分,選擇對應的模式。
生成 2K 產品展示、品牌場景、動態海報或電商廣告,具備協調一致的視覺效果、原生音效、更清晰的指令執行,以及改善的文字與品牌資訊呈現。
使用多張角色與服裝圖片,在簡短的敘事節拍或品牌場景中傳達一致的身份識別。
提供簡短的影片參考,以引導動作、構圖、鏡頭行為或節奏,同時描述您自己的主體。
將連貫的鏡頭、氛圍、鏡頭進程、對白、音效與音樂作為單一視聽序列進行導演,而非將每個模態視為獨立任務。
將表演者或角色參考與音樂、配音或時間指令結合,在單次生成中創作原生立體聲視聽表演概念。
根據詳細的多模態簡報,創作遊戲過場動畫、動態介面、動態海報、產品設計概念與 UI/UX 動態研究。
在 Media.io 上建立影片時,MiniMax H3 中真正重要的功能規格。
| 官方模型名稱 | MiniMax-H3 |
|---|---|
| 輸出解析度 | 官方 API 文件中標示為 2K |
| 原生視聽輸出 | 含原生立體聲音訊的影片,包含語音、音效與音樂的統一建模 |
| 時長 | 4 至 15 秒的整數時長 |
| 建立模式 | 文字生成影片;首幀或首尾幀圖片生成影片;參考素材生成影片 |
| 圖片參考 | 最多 9 個 |
| 影片參考 | 最多 3 個;每個 2–15 秒;合併影片參考時長不超過 15 秒 |
| 音訊參考 | 最多 3 個;每個 2–15 秒;合併音訊參考時長不超過 15 秒 |
| 混合參考上限 | 圖片、影片與音訊參考檔案合計最多 12 個 |
| 畫面比例 | 依提示詞與輸入內容而定;可用選項在 Media.io 介面中可能有所不同 |
| 2K 細節渲染 | 使用原始多模態情境進行情境內重新生成,以改善 2K 解析度下的細小文字與精緻視覺細節 |
| 商業優勢 | 複雜指令執行、文字與品牌資訊呈現、V2V 動作轉移、多模態剪輯,以及原生多鏡頭視聽生成 |
| 重要限制 | 請選擇與您輸入內容相符的建立模式。首幀/末幀控制與混合參考控制在目前已記錄的介面中屬於獨立的工作流程。 |
兩款模型均支援多模態參考與原生音訊,實際選擇取決於商業精準度與電影級複雜度之間的取捨。
| 比較項目 | MiniMax H3 | Seedance 2.0 | 優勢方 |
|---|---|---|---|
| 輸入與參考控制 | 文字、圖片、影片與音訊情境;最多 9 張圖片、3 段影片、3 段音訊片段及 12 個混合檔案 | 文字、圖片、影片與音訊參考,具備相當的 9 張圖片、3 段影片與 3 段音訊上限 | 平手 |
| 解析度與時長 | 原生 2K 輸出,影片最長 15 秒 | 最長 15 秒;官方發布頁面未載明公開的最高解析度 | H3 |
| 原生音訊 | 含語音、音樂與音效聯合建模的原生立體聲音訊 | 雙聲道音訊,具備詳細的語音、音樂、環境音、擬音音效與並行音訊導演功能 | 平手 |
| 商業呈現 | 強烈聚焦於指令執行、產品與品牌資訊、可見文字、廣告、電商、UI/UX 及動態設計 | 強大的商業與電影級輸出,但官方評估仍將文字準確度列為有待改善的領域 | H3 |
| 動作與鏡頭 | 在動作、表演、鏡頭行為與剪輯節奏方面具備強大的 V2V 動作轉移能力 | 在複雜動作、舞蹈編排、多角色互動、鏡頭規劃與物理合理動作方面具有重大優勢 | Seedance |
| 剪輯與續接 | 通用提示詞型多模態剪輯與參考引導式重新生成 | 更明確記錄的目標片段、主體、動作、故事線剪輯與影片續接功能 | Seedance |
| 首尾幀控制 | 明確的首幀與首尾幀工作流程 | 未作為核心官方工作流程強調 | H3 |
| 最適合用途 | 2K 產品廣告、電商、品牌影片、動態海報、UI/UX 概念及受控商業內容 | 動作大量場景、舞蹈與運動、電影級敘事、多角色互動、豐富音效設計及影片續接 | 視情況而定 |
快速結論:當清晰的 2K 細節、產品與品牌呈現、可見文字、首尾幀控制及高效商業製作最為重要時,選擇 MiniMax H3。當複雜動作、多角色互動、電影級導演、沉浸式音效設計或影片續接為優先考量時,選擇 Seedance 2.0。
在 Media.io 中開啟 MiniMax H3,然後選擇文字生成影片、首尾幀圖片生成影片或參考素材生成影片。
上傳首幀與可選的末幀,或切換至參考模式以使用圖片、影片及符合條件的音訊。幀模式與參考模式無法同時使用。
以自然語言描述完整任務:哪個參考控制角色、哪段影片引導動作或鏡頭、音訊應如何塑造語音或音樂,以及哪些品牌、文字或最終構圖必須呈現。
這些評論描述了更廣泛的 Media.io 工作流程體驗,以及創作者對 MiniMax H3 等進階模型的操控期望;這些內容並非作為新上線模型的已驗證評價呈現。
Media.io 的工作流程讓人更容易在同一個地方整理想法、參考資料和創意方向,而不必從空白畫布開始。
對於日常內容而言,清晰的模型與輸入選項可以幫助我們的團隊測試影片方向,而不會增加陡峭的剪輯學習曲線。
我在 Media.io 中重視的是易用性:提示詞與參考輸入讓進階影片概念更容易溝通表達。
對於產品內容,我希望能參考拍攝主體、描述動作與鏡頭,並快速確認該概念是否適合社群活動。
Media.io 讓實驗感覺更加輕鬆。引導式工作流程幫助我專注於角色、動作、構圖和預期成果。
在活動測試方面,以參考素材為主導的生成方式可以探索不同的動作與鏡頭處理方式,同時兼顧創意簡報的核心方向。
Media.io 的工作流程讓人更容易在同一個地方整理想法、參考資料和創意方向,而不必從空白畫布開始。
對於日常內容而言,清晰的模型與輸入選項可以幫助我們的團隊測試影片方向,而不會增加陡峭的剪輯學習曲線。
我在 Media.io 中重視的是易用性:提示詞與參考輸入讓進階影片概念更容易溝通表達。
對於產品內容,我希望能參考拍攝主體、描述動作與鏡頭,並快速確認該概念是否適合社群活動。
Media.io 讓實驗感覺更加輕鬆。引導式工作流程幫助我專注於角色、動作、構圖和預期成果。
在活動測試方面,以參考素材為主導的生成方式可以探索不同的動作與鏡頭處理方式,同時兼顧創意簡報的核心方向。
Media.io 的工作流程讓人更容易在同一個地方整理想法、參考資料和創意方向,而不必從空白畫布開始。
對於日常內容而言,清晰的模型與輸入選項可以幫助我們的團隊測試影片方向,而不會增加陡峭的剪輯學習曲線。
MiniMax H3 是一款於 2026 年 7 月 31 日推出的通用全模態生成模型。它整合了文字、圖像、影片與音訊情境,讓創作者能以自然語言描述複雜的生成或編輯任務,並生成最長 15 秒的 2K 影片,同時附帶原生立體聲音訊。
MiniMax H3 在共享提示詞情境中支援圖像、影片與音訊參考素材。您可以描述哪個素材定義角色或產品、哪個片段引導動作或鏡頭運用,以及哪段音訊引導人聲、歌曲或節奏。
上限為 9 張圖像、3 部影片和 3 個音訊片段,混合檔案總數不超過 12 個。每個影片或音訊參考素材長度須為 2 至 15 秒,且每種類型的合計時長上限為 15 秒。
是的。官方 API 文件列出了 2K 輸出規格,以及 4 至 15 秒的整數時長選項。Media.io 的控制項取決於目前的實作狀況。
是的。MiniMax 將 H3 描述為能生成原生立體聲視聽輸出,人聲、音效與音樂一併建模,而非作為獨立的靜音影片後製步驟另行添加。參考音訊也可協助定義預期的人聲、歌曲、時間點或節奏。
不行。幀圖像轉影片與參考素材轉影片是兩種獨立模式。首幀可單獨使用,但末幀需要搭配首幀才能使用。
它特別適合廣告與電子商務影片、品牌與產品展示、電影片頭、動態海報、遊戲過場動畫、UI/UX 動態概念、一致性角色場景、V2V 動作遷移,以及其他結合視覺參考素材、動作、文字與聲音的商業工作流程。
請使用Media.io 上的 MiniMax H3 頁面並登入以查看可用性、控制項及點數需求。系統可能提供入門或推廣點數,但條款可能隨時變更。請參閱官方指南以了解模型詳情。
 4.7(162,387 票)


