
 ChatGPT
 Perplexity
 Gemini
 Claude
 Grok
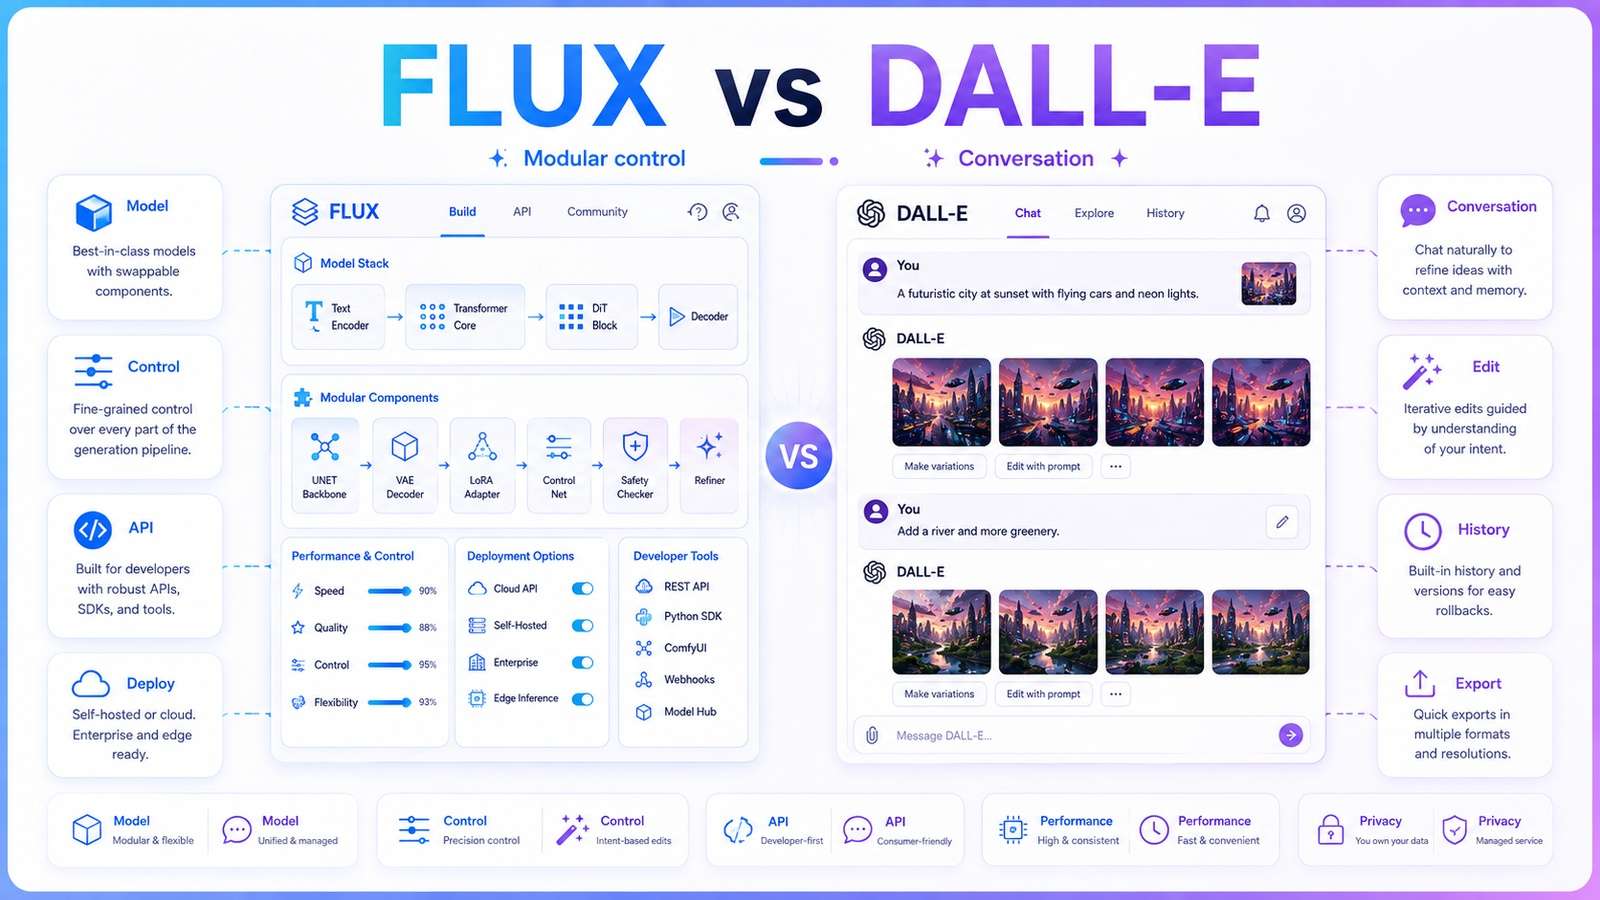
FLUX vs DALL-E deve ser testado após a primeira imagem atraente. Em 2026, os modelos relevantes são FLUX.2 e GPT-Image-2, não apenas FLUX.1 contra DALL-E 3. Ambos podem gerar e editar imagens, seguir instruções detalhadas e lidar com texto. A diferença entre eles fica mais clara quando um produto, pessoa, layout e cor de marca precisam sobreviver a várias revisões.
Neste artigo
Compare FLUX.2 com GPT-Image-2, Não com Memórias Antigas de Marcas
O Black Forest Labs recomenda o FLUX.2 para projetos atuais de texto para imagem e edição. A família inclui opções Pro e Max com foco em qualidade, Flex para tipografia e pequenos detalhes, e variantes Klein projetadas para velocidade e implantação selecionada de pesos abertos. O FLUX.2 suporta edição com múltiplas referências, instruções exatas de cores, proporções de aspecto flexíveis e saídas de até 4MP em rotas compatíveis.
O modelo de desenvolvedor atual da OpenAI é o GPT-Image-2, enquanto os usuários do ChatGPT interagem com o ChatGPT Images 2.0. Ele suporta geração e edição de imagens com entradas de imagem de alta fidelidade e uma interface conversacional no ChatGPT. A palavra-chave DALL-E continua útil para pesquisa, mas as decisões de produção devem nomear o modelo e endpoint atuais.
FLUX Expõe uma Família de Modelos; OpenAI Conecta Imagens à Conversa
| Capacidade | FLUX.2 | GPT-Image-2 / ChatGPT Images |
|---|---|---|
| Edição com múltiplas referências | Suporte explícito para combinar múltiplas imagens de entrada | Entradas de imagem de alta fidelidade e edição conversacional |
| Controle exato de cores | Suporta instruções como cores HEX em fluxos de trabalho relevantes | Descreva a cor desejada e revise de forma conversacional |
| Rota de tipografia | A variante Flex é especializada em tipografia e detalhes | A geração de imagens atual da OpenAI enfatiza texto preciso |
| Caminho de pesos abertos | Disponível para variantes Klein selecionadas sob suas licenças | Sem pesos GPT-Image-2 para download |
| API | Endpoints oficiais específicos por modelo | Endpoints de geração e edição de imagens da OpenAI |
| Fluxo de trabalho para consumidores | Acesso por meio de provedores e aplicativos | Conversa no ChatGPT e editor de imagens |
O FLUX.2 pode ser tratado como um componente selecionado para uma tarefa: qualidade máxima, iteração rápida, tipografia ou controle local. A OpenAI oferece um modelo de interação mais unificado: discuta o briefing, faça upload de referências, gere e continue alterando o ativo em contexto. Os desenvolvedores ainda precisam converter essa lógica criativa em chamadas de API repetíveis.
Execute um Benchmark de Campanha de Produto em Três Rodadas
Use uma embalagem ou dispositivo real em vez de um retrato genérico. Prepare uma referência de produto limpa, recorte de logotipo e etiqueta, paleta, referência de fundo e esboço de layout.
- Rodada um - criação: posicione o produto em uma nova cena com câmera, superfície, iluminação e espaço de texto vazio exatos.
- Rodada dois - adaptação: crie variantes quadradas e verticais preservando a escala do produto, geometria, etiqueta e material.
- Rodada três - correção: altere um acessório, uma cor HEX e uma linha de texto sem modificar mais nada.
Pontue cada rodada de forma independente. Um modelo pode vencer na criação e perder na correção. Registre o desvio na forma do produto, mutações em etiquetas, mudanças inesperadas de enquadramento, alterações em rostos ou mãos, incompatibilidade de iluminação, rerrolagens e o número de correções manuais necessárias antes da aprovação.
Os controles de múltiplas referências e cores do FLUX.2 são diretamente relevantes para a consistência do produto. O ponto forte do GPT-Image-2 é interpretar intenções complexas de revisão em linguagem natural. O resultado dependerá da variante exata, nível de qualidade, referências e design de prompt — não do nome da empresa.
Torne a rodada três intencionalmente difícil
A rodada um deve estabelecer o produto aprovado e a direção de arte. A rodada dois deve adaptá-lo a um novo canal e ponto de vista. A rodada três deve solicitar uma correção específica após essas alterações — por exemplo, corrigir uma linha de texto, substituir um acessório refletido em vidro ou alterar a manga de um modelo mantendo a pose e a embalagem fixas. Isso expõe o desvio acumulado que um benchmark de primeira geração não consegue detectar.
Pontue cada rodada quanto à conformidade com o prompt, geometria do produto, identidade de referência, cor exata, texto legível, área de mudança não intencional, latência e minutos de reparo manual. Mantenha as saídas anônimas durante a revisão. Um modelo que vence a rodada um, mas perde a identidade da marca após a rodada três, pode ser ideal para arte conceitual e inadequado para um pipeline de campanha automatizado.
A Decisão de API É uma Decisão de Arquitetura
Escolha o provedor somente após responder onde os arquivos estão armazenados, como os prompts são versionados, se os resultados são consultados ou transmitidos, como as falhas são repetidas, qual alias de modelo está fixado e como o custo e a moderação são monitorados. Um protótipo que funciona em uma interface web pode falhar em produção porque sua conversa oculta, ordenação de referências ou seleção manual nunca foi capturada.
- Fixe snapshots de modelos ou endpoints estáveis quando disponíveis.
- Armazene a ordem de entrada e o papel de cada imagem de referência.
- Versione os prompts e restrições negativas junto com o ativo.
- Registre latência, tentativas repetidas, falhas de segurança e saídas rejeitadas.
- Mantenha uma etapa de aprovação humana para pessoas, marcas, afirmações e texto de embalagem.
O FLUX oferece vários endpoints e rotas selecionadas auto-hospedáveis, criando mais opções de arquitetura. A OpenAI fornece uma plataforma única e mais abrangente com endpoints de imagem atuais e o ChatGPT como interface interativa. Mais opções melhoram a otimização, mas aumentam a configuração e a manutenção.
Mantenha um Registro de Falhas de Segunda Edição
Projete para mudança de endpoint antes do lançamento
| Camada de arquitetura | Escolha de design portátil | Aviso de bloqueio |
|---|---|---|
| Briefing | Requisitos estruturados independentes da sintaxe do prompt | A lógica de negócios reside em um único prompt longo |
| Referências | Armazenamento normalizado, consentimento, recorte e metadados de cores | Os ativos são preparados apenas para um endpoint |
| Geração | O adaptador mapeia campos compartilhados para FLUX ou GPT Image | As chamadas de aplicação estão dispersas pelo código-base |
| Avaliação | Testes de aceitação neutros ao modelo e revisão humana | O sucesso é definido pela estética de um único modelo |
| Auditoria | Modelo, versão, entradas, saída e edições são registrados | Os arquivos aprovados não podem ser rastreados até uma solicitação |
A estrutura familiar do FLUX.2 torna o roteamento explícito de modelos atraente: Flex para trabalhos com tipografia intensa, Max ou Pro para qualidade, e variantes Klein selecionadas para implantação controlada. O GPT-Image-2 oferece uma rota gerenciada mais simples dentro da plataforma OpenAI. Em ambos os casos, um adaptador e uma camada de avaliação neutra ao modelo reduzem o custo de mudança de endpoints quando a qualidade, a política, a latência ou o preço mudam.
Crie uma tabela para cada ativo de teste com a alteração solicitada, elementos preservados, alterações não intencionais, rerrolagens, latência, custo e tempo de reparo manual. Revise-a após dez tarefas. Isso evita que um primeiro render memorável supere falhas repetidas em produção.
Para equipes que não precisam de APIs de modelo direto ou pesos abertos, Media.io Text to Image oferece criação multi-modelo baseada em navegador, e Image to Image suporta transformações por referência. É um fluxo de trabalho mais simples para criadores, não um substituto para o controle em nível de endpoint.
Separe o benchmark criativo do benchmark de sistemas. Um líder criativo deve avaliar as imagens anônimas quanto à precisão do briefing, hierarquia, texto legível, continuidade do assunto e esforço de reparo. Um engenheiro deve avaliar latência, tratamento de falhas, limites de imagem de referência, tamanho de saída, comportamento de moderação, registro e o trabalho necessário para reproduzir um resultado aceito. Combinar essas pontuações evita que a preferência visual ou a conveniência de infraestrutura decida sozinha.
Teste também a substituição de modelos. Execute a mesma solicitação por duas variantes do FLUX.2 e pelo GPT-Image-2, depois substitua um componente no aplicativo. Se alterar o modelo forçar reescritas de prompt, mudanças no pipeline de ativos ou novas regras de revisão, esse custo de migração deve fazer parte da decisão. Uma pilha de API aparentemente flexível ainda pode criar bloqueio por meio de prompts, preparação de referências e limites de aceitação.
Modele a incerteza explicitamente
Uma estimativa de produção deve conter intervalos, não um único número de vitrine. Meça a latência mediana e no pior caso, saídas aceitas por solicitação, edições adicionais por ativo aceito, falhas de moderação ou validação e a porcentagem de tarefas que exigem um fallback humano. Repita a medição para tipografia, fidelidade de produto, pessoas e composição com múltiplas referências, pois uma pontuação agregada pode ocultar uma classe de falha crítica.
Em seguida, crie regras de roteamento. Um banner com tipografia intensa pode usar um endpoint FLUX.2 especializado em texto; um briefing criativo ambíguo pode seguir para um fluxo GPT Image conversacional; uma tarefa sensível ou de alto volume pode justificar uma implantação controlada. O roteamento é mais realista do que declarar um modelo o vencedor universal, mas só funciona se os dados de avaliação e os registros de auditoria usarem as mesmas definições em todos os endpoints.
Por fim, preveja o orçamento para a deriva do modelo atual. Provedores hospedados melhoram e substituem sistemas, enquanto implantações de pesos abertos preservam um artefato escolhido, mas exigem manutenção. Fixe o que puder ser fixado, mantenha briefings de teste de referência e execute-os novamente após qualquer alteração de modelo, prompt ou pré-processamento.
Saiba quando o roteamento multi-modelo é excesso de engenharia
Uma camada de roteamento faz sentido quando o volume, o custo de falha ou a diversidade de tarefas pode compensar o trabalho de engenharia. Ela é desnecessária para uma equipe pequena que produz algumas imagens de campanha manualmente. Nesse caso, o fluxo conversacional gerenciado do ChatGPT ou um único endpoint FLUX hospedado pode entregar mais valor do que uma abstração projetada para escala hipotética.
Rejeite a rota FLUX se a organização não conseguir manter a implantação de pesos abertos selecionada ou não conseguir documentar a variante hospedada exata por trás dos ativos aceitos. Rejeite a rota OpenAI se o fluxo de trabalho exigir custódia do modelo, um limite de implantação que ela não pode fornecer ou controle determinístico em nível de componente. Essas são restrições de arquitetura, não reclamações sobre qualidade de prompt.
Perguntas Frequentes sobre FLUX vs DALL-E
-
O DALL-E ainda é o modelo de imagem atual da OpenAI?
Não. A experiência atual para consumidores é o ChatGPT Images, e o modelo atual para desenvolvedores inclui o GPT-Image-2. DALL-E continua sendo uma palavra-chave de comparação comum. -
Qual modelo FLUX deve ser comparado com o DALL-E?
Comece com o FLUX.2 Pro para uma comparação geral hospedada, depois teste o Max para qualidade, o Flex para tipografia e detalhes, ou o Klein para velocidade e implantação elegível de código aberto. -
Qual é melhor para consistência de produto?
O FLUX.2 oferece fluxos de trabalho explícitos com múltiplas referências e controles de cor, enquanto o GPT-Image-2 oferece entradas de imagem robustas e edições orientadas por instruções. Teste várias revisões no mesmo produto. -
O FLUX pode ser executado localmente?
Determinadas variantes do FLUX.2 Klein possuem rotas de peso aberto projetadas para GPUs de consumo. Outros modelos FLUX são acessados sob diferentes condições de API ou licença. -
Qual é melhor para uma API de aplicação?
Ambos fornecem APIs de imagem atuais. Escolha após testar a qualidade necessária, o tratamento de referências, a latência, os preços, as políticas, a observabilidade e o nível de especialização de endpoints que sua equipe consegue manter.