Se o narrador mudar ligeiramente a cada vez que a cena muda, o público percebe mesmo quando não consegue explicar o motivo. A consistência de voz não diz respeito apenas ao timbre. Ritmo, sotaque, respiração, emoção, pronúncia, volume e características do ambiente podem fazer com que o mesmo locutor sintético pareça uma pessoa diferente.
O Curious Refuge compara esses três fluxos de trabalho em um tutorial dedicado à consistência de voz. Assista ao contraste primeiro e, em seguida, use o restante deste guia para transformar a voz preferida em uma especificação de série repetível com roteiros controlados, configurações, entrega multilíngue, normalização e controle de qualidade.
Neste artigo
- Defina o que "A Mesma Voz" Significa para o Seu Projeto
- Use o Mesmo Ativo de Voz, Não um Similar
- Comece com Áudio de Referência Limpo e Consistente
- Bloqueie as Configurações de Voz em Toda a Série
- Padronize o Roteiro Antes de Gerar o Áudio
- Gere em Segmentos Gerenciáveis
- Mantenha o Alcance Emocional Deliberado
- Combine a Voz Entre Idiomas com Cuidado
- Normalize o Áudio Final, Não Apenas as Configurações do Gerador
- Use um Clipe de Referência de Voz Durante o Controle de Qualidade
- Crie um Fluxo de Trabalho de Voz Repetível no Media.io
- Lista de Verificação de Consistência de Voz com IA
- Mantenha as Versões do Modelo e do Fluxo de Trabalho sob Controle
- Perguntas Frequentes sobre Consistência de Voz com IA
Defina o que "A Mesma Voz" Significa para o Seu Projeto
A identidade de voz é apenas uma parte da consistência. Dois clipes podem usar a mesma voz sintética e ainda assim soar como produções diferentes.
Defina o objetivo em várias dimensões:
| Dimensão de consistência | O que bloquear |
| Identidade vocal | timbre, sotaque, idade aparente e caráter central. |
| Entrega | calma, enérgica, conversacional, autoritária ou lúdica. |
| Ritmo | palavras por minuto aproximadas e estilo de pausa. |
| Emoção | linha de base neutra e alcance emocional permitido. |
| Caráter de gravação | estúdio seco, cabine aquecida, microfone próximo ou outro som consistente. |
| Volume | um nível alvo para exportações finais. |
| Pronúncia | nomes, siglas, produtos, lugares e termos técnicos. |
Escreva isso em uma especificação de voz. Uma especificação útil pode dizer: "Narradora feminina calorosa, inglês americano neutro e claro, ritmo médio, confiante mas sem exagero comercial, pausas curtas entre frases, sem respiração exagerada, som de estúdio seco, pronúncia consistente do nome do produto."
A especificação de voz torna-se a referência para cada roteiro e revisão de controle de qualidade.
Use o Mesmo Ativo de Voz, Não um Similar
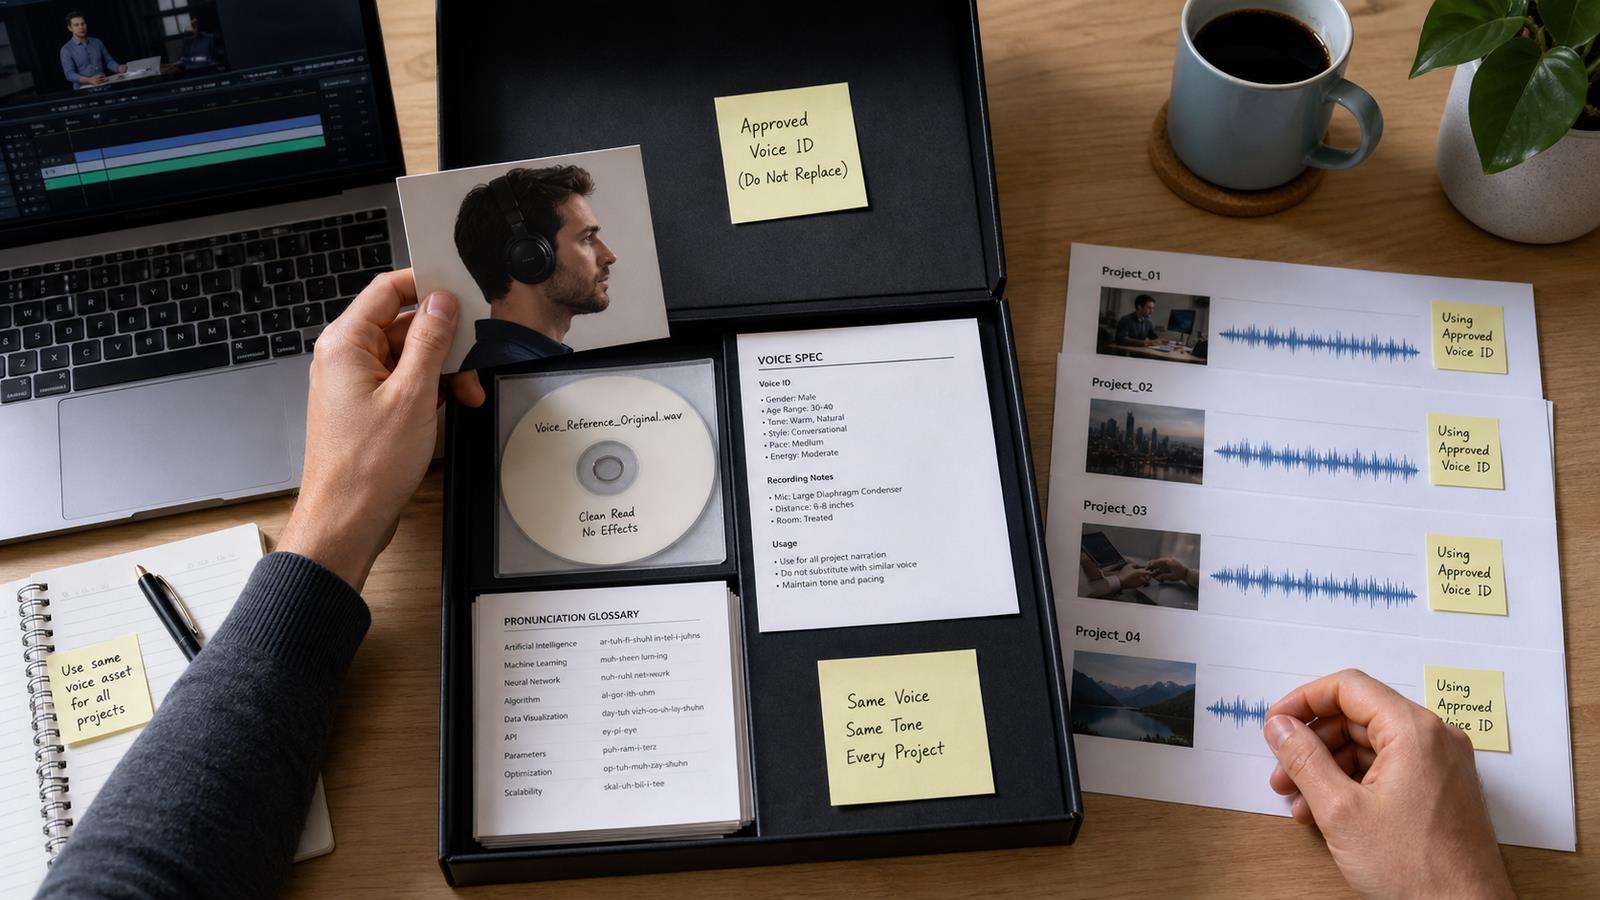
Se uma plataforma fornecer um ID de voz, voz salva ou voz clonada, reutilize exatamente o mesmo ativo em toda a série. Não escolha uma nova voz apenas porque sua prévia parece próxima.
Para vozes clonadas, mantenha as gravações de origem originais. O ElevenLabs observa que recriar um clone a partir das mesmas amostras ainda pode produzir um clone ligeiramente diferente. Esse é mais um motivo para preservar o ativo de voz aprovado em vez de reconstruí-lo posteriormente.
O fluxo de trabalho de Clonagem de Voz com IA do Media.io pode ser usado para criar uma voz reutilizável para narração, marketing, educação ou dublagem de vídeo. Quando a consistência é importante, trate o clone aprovado como um ativo de produção nomeado e registre quais projetos o utilizam.
Comece com Áudio de Referência Limpo e Consistente
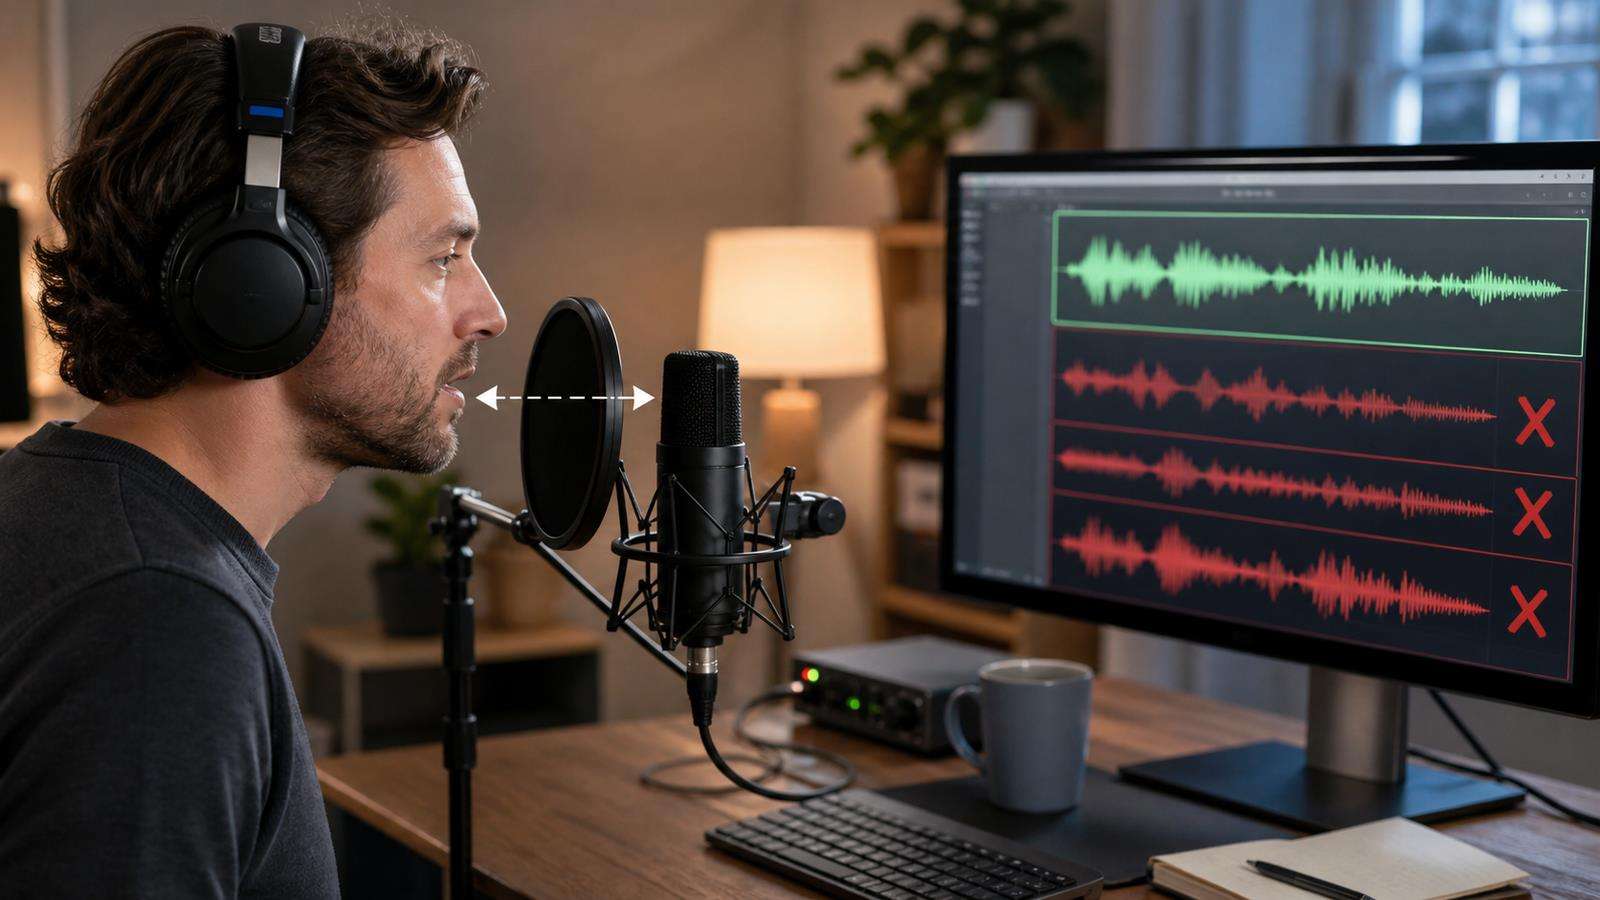
Um clone aprende com o que ouve. Ruído de fundo, reverberação do ambiente, mudança de microfones, grandes variações de volume e estilos de performance misturados podem tornar a voz gerada menos previsível.
O ElevenLabs recomenda gravações limpas de um único locutor com volume, tom, qualidade de áudio e performance consistentes. Para seu fluxo de trabalho de Clonagem de Voz Instantânea, recomenda aproximadamente um a dois minutos de bom áudio. A clonagem profissional requer muito mais material, mas o princípio importante é o mesmo: qualidade e consistência importam mais do que coletar minutos aleatórios de fala.
Grave a voz que você realmente deseja reproduzir. Se o objetivo é um narrador corporativo calmo, não misture sussurros, gritos, atuação de personagem e gravações casuais de telefone no mesmo conjunto de referência. Se você deseja vários modos emocionais, gerencie-os deliberadamente em vez de deixar os dados de treinamento se tornarem uma mistura acidental.
Bloqueie as Configurações de Voz em Toda a Série
Muitos sistemas de TTS expõem controles que afetam a consistência. Os nomes diferem por plataforma, mas os controles comuns incluem estabilidade, similaridade, estilo, velocidade, tom, emoção e idioma.
Registre as configurações usadas para o clipe aprovado. Se você alterar a estabilidade ou o estilo de um vídeo para outro, estará intencionalmente mudando o comportamento da voz.
O ElevenLabs descreve a estabilidade como um controle sobre o quanto a saída adere à referência e quanto de aleatoriedade aparece entre as gerações. Ele também alerta que uma exageração de estilo mais forte pode reduzir a estabilidade. Essa é uma lição geral útil: configurações projetadas para expressividade podem tornar uma série menos uniforme.
Para produção, estabeleça uma predefinição de linha de base. Crie predefinições nomeadas separadas apenas quando o conteúdo realmente precisar delas, como Narrador_Neutro, Narrador_Animado e Narrador_Suave. Não ajuste os controles deslizantes por intuição em cada clipe.
O Text to Speech do Media.io também permite escolhas de voz, idioma, velocidade e tom. Mantenha essas escolhas registradas quando uma sequência de vídeos precisar compartilhar um estilo de narração.
Padronize o Roteiro Antes de Gerar o Áudio
A variação de voz pode vir da formatação do texto, não apenas do modelo de voz.
Crie regras de roteiro para:
- Comprimento das frases.
- Estilo de pontuação.
- Números e datas.
- Siglas.
- Nomes de produtos.
- URLs.
- Pausas.
- Ênfase.
- Palavras estrangeiras.
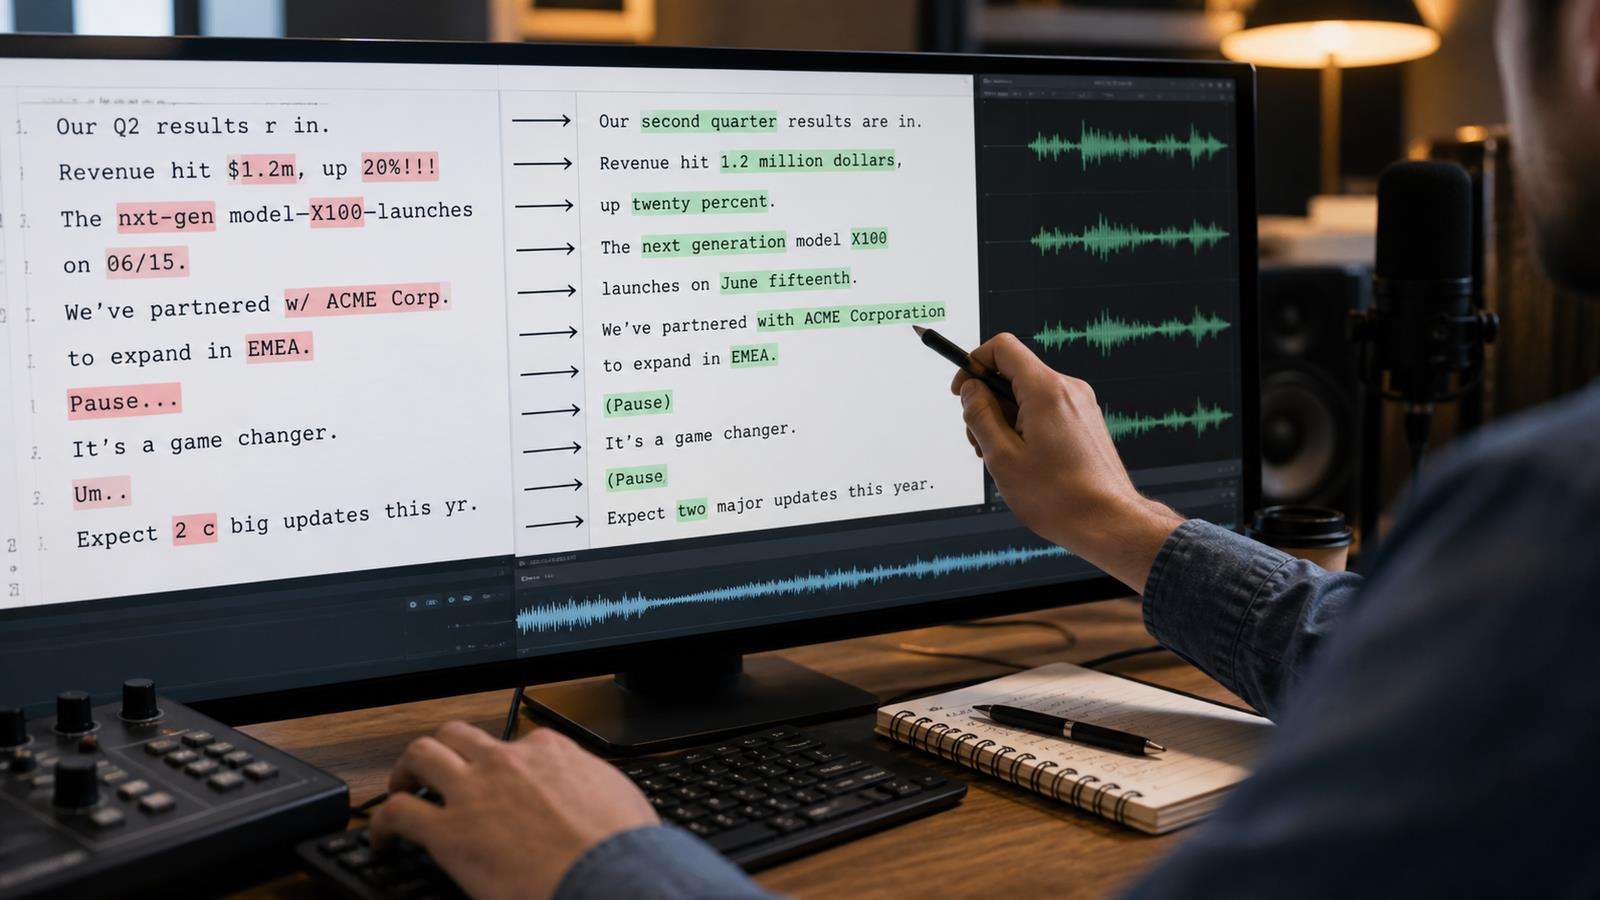
Se um roteiro escreve "2026" e outro escreve "dois mil e vinte e seis," a pronúncia pode diferir. Se um usa "IA" e outro usa "I.A.," a cadência pode mudar. Se o mesmo nome de produto às vezes é hifenizado e às vezes não, o modelo pode pronunciá-lo de forma diferente.
Crie um glossário de pronúncia. Escreva termos difíceis foneticamente quando o sistema suportar, ou use uma forma de texto estável que você já testou.
Gere em Segmentos Gerenciáveis
Gerações longas podem apresentar variações de energia, volume, ritmo ou pronúncia. Dividir um roteiro em segmentos lógicos menores facilita a regeneração apenas da linha fraca e sua comparação com uma referência.
As orientações de solução de problemas do ElevenLabs sugerem especificamente dividir o texto em segmentos menores quando o volume ou a qualidade varia em gerações mais longas. Um segmento pode ser um parágrafo, uma cena ou de 10 a 30 segundos de narração, dependendo da ferramenta e do conteúdo.
Não transforme cada frase em um arquivo separado, a menos que a performance fique muito fragmentada. Agrupe frases que pertencem a um mesmo pensamento para que a prosódia flua naturalmente. Deixe pontos de edição no início e no final para o tempo.
Nomeie os arquivos sistematicamente, por exemplo:
EP04_S03_VO_01.wav
EP04_S03_VO_02.wav
Isso facilita rastrear uma linha de volta ao roteiro e regenerar apenas o segmento necessário.
Mantenha o Alcance Emocional Deliberado
Consistência não significa entrega monótona. Um narrador pode soar mais animado para uma revelação e mais calmo para uma explicação, mantendo-se ainda assim a mesma voz. A chave é definir o alcance.
Crie um pequeno mapa emocional para a série:
- Gancho: enérgico, frases curtas.
- Explicação: neutro e claro.
- Aviso: mais lento e mais sério.
- CTA: caloroso, confiante, sem gritar.
Se um clipe usa de repente uma performance teatral que não existe em nenhum outro lugar, soará como outro narrador. Mantenha o estilo emocional conectado à voz de linha de base.
Quando o sistema oferece controles altamente expressivos, gere múltiplos candidatos e escolha o mais próximo da sua referência aprovada. Não assuma que a interpretação mais dramática é a melhor.
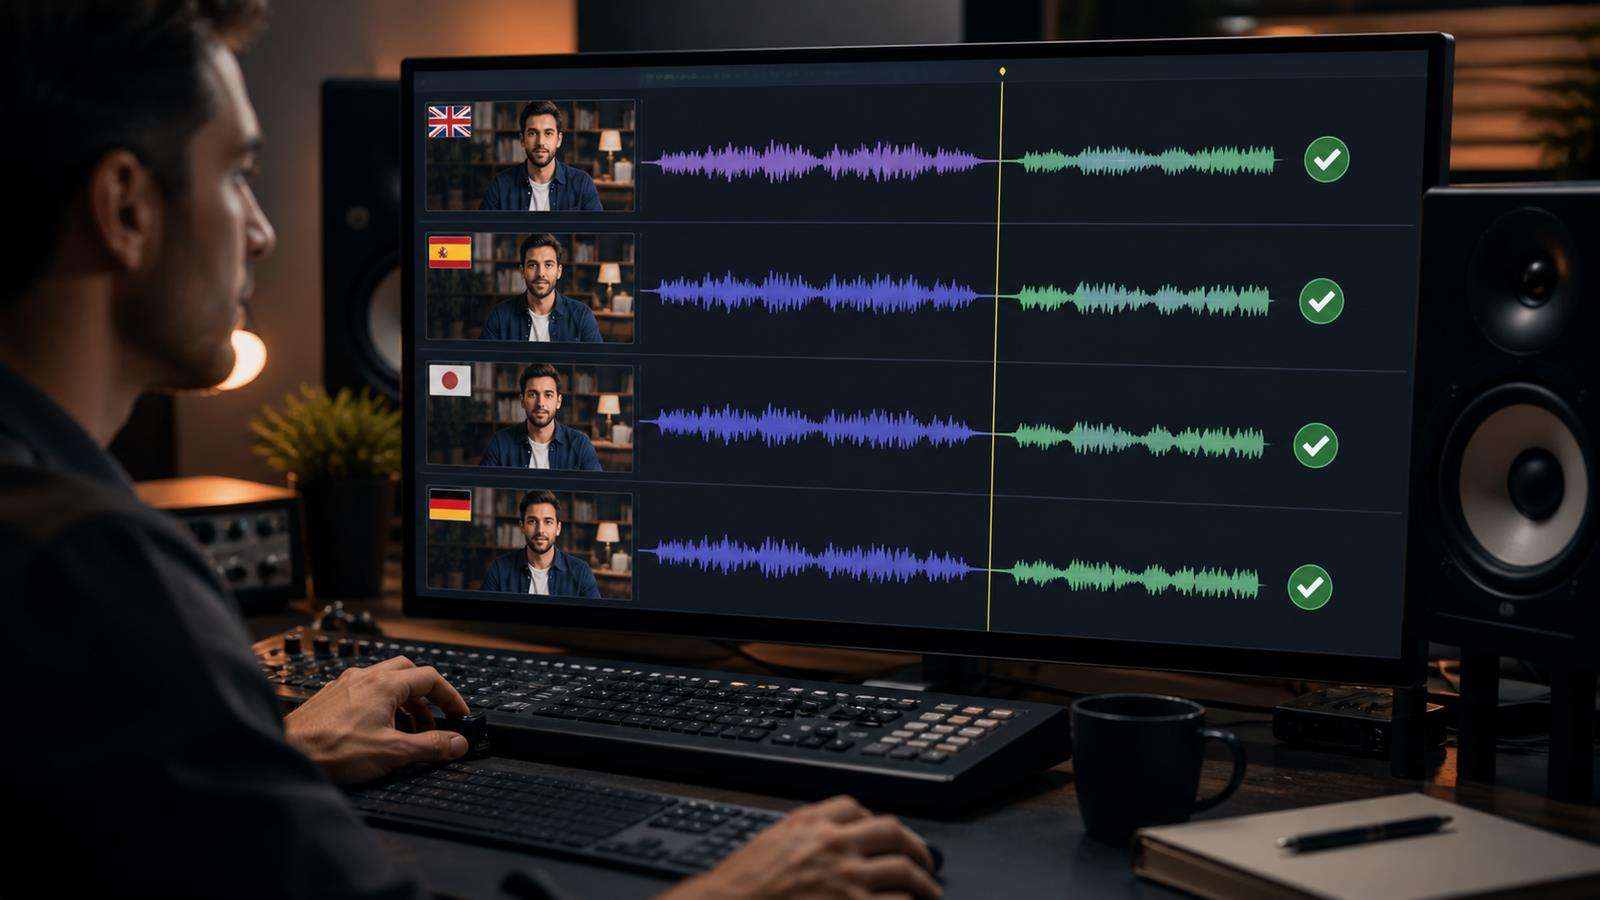
Combine a Voz Entre Idiomas com Cuidado
A produção multilíngue introduz outra camada. Uma voz clonada em inglês falando espanhol ou japonês pode manter alguma identidade, mas mudar sotaque, ritmo ou pronúncia. O ElevenLabs observa que vozes clonadas podem carregar o sotaque do idioma usado nas gravações de origem ao falar outro idioma.
Decida o que a consistência significa em diferentes mercados. Você pode priorizar uma identidade de voz global única, ou pode priorizar uma entrega local nativa com vozes em diferentes idiomas-alvo. Ambas são estratégias de marca válidas.
Para um vídeo falado existente, o AI Lip Sync do Media.io pode sincronizar o áudio substituto ao locutor visível. Para um apresentador estático, o AI Talking Avatar pode criar fala a partir de uma imagem e roteiro ou áudio.
Normalize o Áudio Final, Não Apenas as Configurações do Gerador
Dois clipes podem usar configurações idênticas de TTS e ainda assim ter diferentes volumes percebidos após a edição. Música de fundo, compressão, redução de ruído e configurações de exportação de vídeo afetam o som final.
Crie um predefinição de finalização de áudio para a série. No mínimo, verifique:
- Sonoridade.
- Nível de pico.
- Piso de ruído.
- Equalização.
- Compressão.
- De-essing quando necessário.
- Tom ambiente ou ambiência.
- Nível da música sob a narração.
Aplique a mesma cadeia de finalização, a menos que um clipe tenha um motivo específico para ser diferente. Se algumas referências de origem contiverem ruído, limpe-as antes de clonar. O Redutor de Ruído com IA da Media.io pode ajudar na limpeza quando um som de fundo indesejado faz parte da fonte ou da trilha de voz final.
Use um Clipe de Referência de Voz Durante o Controle de Qualidade
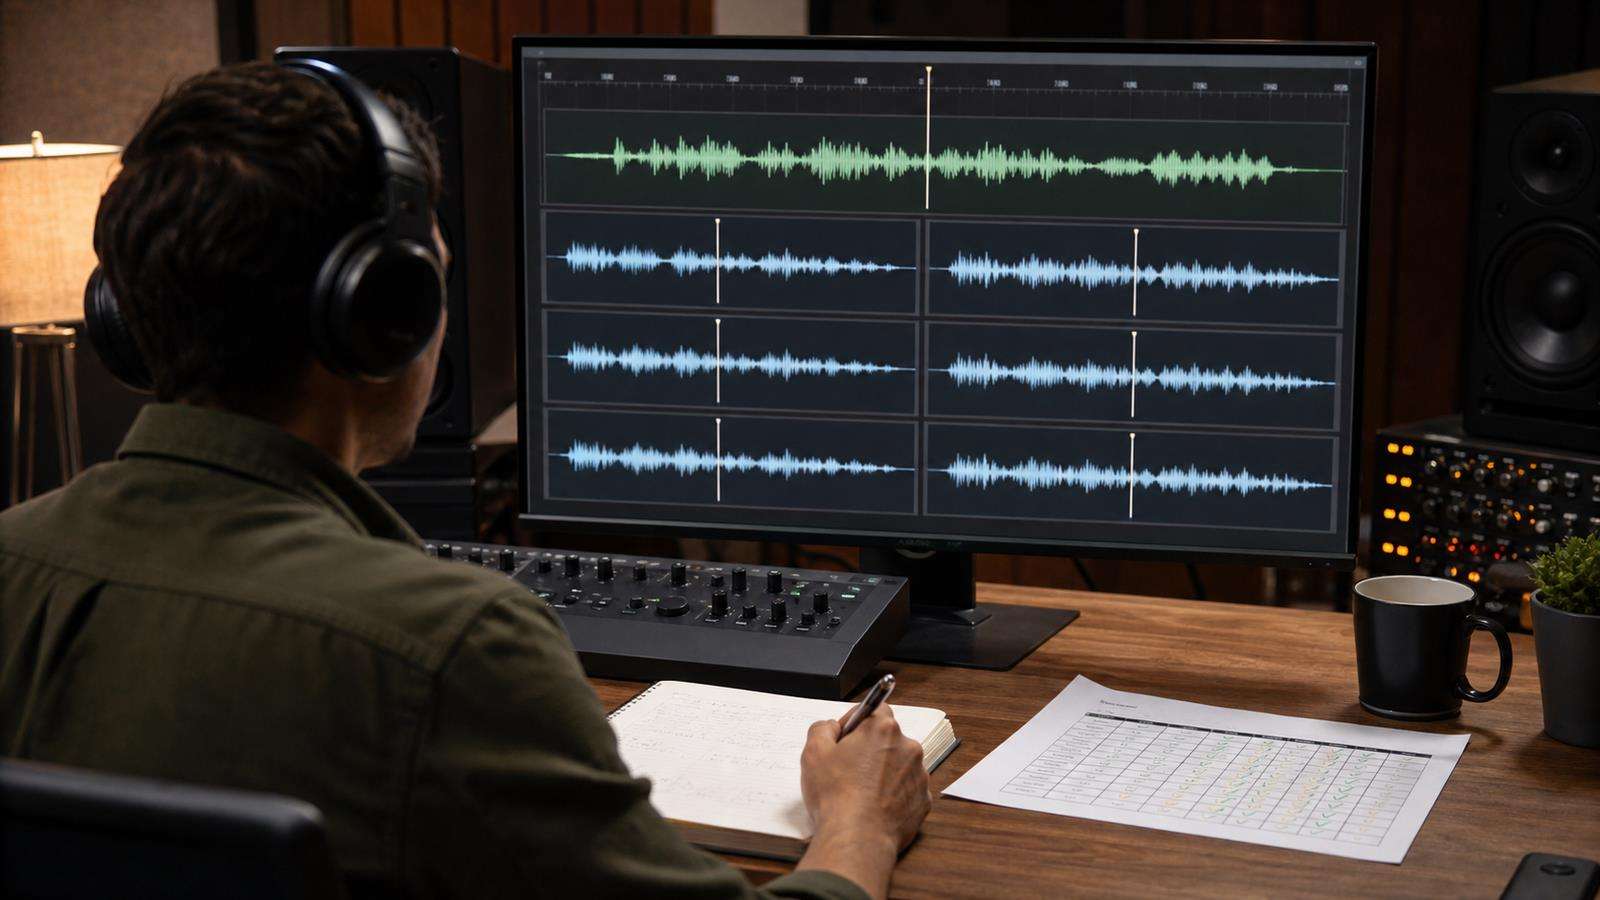
Não confie na memória. Mantenha uma referência de voz aprovada e curta ao lado de cada sessão de revisão. Reproduza a referência e, em seguida, reproduza o novo clipe.
Compare:
- Sotaque e timbre.
- Ritmo.
- Energia emocional.
- Pronúncia.
- Respiração.
- Sonoridade.
- Ambiente ou caráter de processamento.
Uma comparação lado a lado torna muito mais fácil perceber pequenas variações. Para uma série longa, crie um reel de contato com uma frase de cada episódio. Ouvir as amostras uma após a outra revela mudanças graduais que podem ser invisíveis durante uma aprovação isolada.
Crie um Fluxo de Trabalho de Voz Repetível no Media.io
Para um narrador estável, crie ou selecione a voz uma vez e, em seguida, mantenha suas configurações e convenções de roteiro consistentes. Gere a narração em seções gerenciáveis, revise-a com base na referência aprovada e insira o áudio final no fluxo de trabalho do vídeo.
Se você precisar de um clone reutilizável, comece com Clonagem de Voz com IA da Media.io. Se você precisar de uma voz pronta com controles de velocidade e tom, use Text to Speech. Se o vídeo final já contiver um rosto falando, use a Sincronização Labial após o áudio localizado ou corrigido ser aprovado.
Lista de Verificação de Consistência de Voz com IA
Antes de publicar um lote de clipes, confirme:
- A mesma voz ou clone aprovado é usado em todo o conteúdo.
- O áudio de referência é limpo e consistente.
- As configurações de voz estão salvas e inalteradas, salvo se documentado.
- A formatação do roteiro segue um único padrão.
- Nomes de produtos e termos difíceis seguem um glossário de pronúncia.
- Roteiros longos são divididos em segmentos gerenciáveis.
- A interpretação emocional permanece dentro do intervalo aprovado.
- O áudio final utiliza a mesma abordagem de sonoridade e processamento.
- Cada novo clipe é comparado com uma amostra de referência.
- As versões multilíngues seguem uma estratégia intencional de identidade versus sotaque nativo.
Uma voz de IA consistente não é criada por uma única configuração perfeita. É o resultado de um pipeline repetível que controla a entrada, a geração, o roteiro, a performance e o pós-processamento.
Mantenha as Versões do Modelo e do Fluxo de Trabalho sob Controle
Uma voz pode variar mesmo quando o roteiro e as configurações permanecem os mesmos, se o modelo de fala subjacente mudar. As ferramentas de produção melhoram ao longo do tempo, e um novo modelo pode lidar com emoção, pausas, pronúncia ou clonagem de forma diferente. Registre a versão do modelo ou do fluxo de trabalho usada para uma série aprovada quando a plataforma expuser essa informação.
Antes de migrar um canal de longa duração para um novo modelo, gere um roteiro de referência curto com a configuração antiga e a nova. Inclua os nomes de produtos, números, faixa emocional e padrões de frases que aparecem com frequência na série. Compare ambas as versões com a voz de referência aprovada antes de trocar todo o pipeline.
Se o novo modelo for melhor, mas visivelmente diferente, trate a mudança como uma decisão de rebranding. Atualize toda a série a partir de um ponto planejado ou mantenha o fluxo de trabalho antigo para o conteúdo existente até que uma transição limpa seja possível. Mudanças silenciosas de modelo são uma razão pela qual um narrador pode parecer evoluir ao longo do tempo, mesmo quando ninguém alterou intencionalmente a voz.
Perguntas Frequentes sobre Consistência de Voz com IA
Por que a mesma voz de IA soa diferente entre os clipes?
A geração de fala por IA não é perfeitamente determinística. Diferenças no áudio de referência, texto, pontuação, configurações, direção emocional, duração do segmento e pós-processamento podem alterar o resultado.
Como manter uma voz clonada consistente?
Use áudio de referência limpo de um único locutor, mantenha o tom e a performance consistentes, reutilize o mesmo clone, salve as configurações de geração, padronize a formatação do roteiro e compare as novas saídas com uma referência aprovada.
Devo gerar uma narração longa ou vários clipes pequenos?
Use seções gerenciáveis. Gerações muito longas podem apresentar variações, enquanto a geração frase a frase pode soar desconectada. Agrupe frases relacionadas em segmentos lógicos curtos que sejam fáceis de regenerar e editar.
Quais configurações afetam a consistência da voz de IA?
Dependendo da plataforma, estabilidade, similaridade, estilo, velocidade, tom, emoção, idioma e escolha de modelo podem afetar a interpretação. Salve um predefinição aprovada em vez de ajustar as configurações de forma diferente para cada clipe.
Como posso manter os nomes de produtos pronunciados da mesma forma em cada vídeo?
Crie um glossário de pronúncia e use a mesma grafia ou forma fonética em cada roteiro. Teste nomes difíceis uma vez e torne a forma aprovada parte do modelo de produção.
Uma voz de IA pode permanecer consistente em diferentes idiomas?
A identidade da voz frequentemente pode ser preservada em certa medida, mas o sotaque e a pronúncia podem mudar. Decida se a marca valoriza uma identidade vocal global única ou uma entrega regional mais nativa, e então use essa estratégia de forma consistente.