如果每次場景切換時旁白略有變化,觀眾即使無法解釋原因,也會察覺到。聲音的一致性不僅關乎音色。語速、口音、氣息感、情緒、發音、音量以及空間特性,都可能讓同一個合成聲音聽起來像不同的人。
Curious Refuge 在一個專屬的聲音一致性教學中比較了這三種工作流程。請先觀看對比示範,再利用本指南的其餘部分,透過受控的腳本、設定、多語言傳遞、音量標準化及品質確認,將偏好的聲音轉化為可重複使用的系列規格。
本文內容
定義「相同聲音」對您專案的意義
聲音識別性只是一致性的一部分。兩個片段即使使用相同的合成聲音,聽起來仍可能像是不同的製作內容。
從多個維度定義目標:
| 一致性維度 | 需要鎖定的項目 |
| 聲音識別性 | 音色、口音、表觀年齡及核心性格特徵。 |
| 表達方式 | 沉穩、充滿活力、對話式、權威感或活潑風趣。 |
| 語速 | 大約每分鐘字數及停頓風格。 |
| 情緒 | 中性基準線及允許的情緒表達範圍。 |
| 錄音特性 | 乾燥的錄音室、溫暖的錄音間、近距離麥克風或其他一致的聲音風格。 |
| 音量 | 最終輸出的目標音量水平。 |
| 發音 | 人名、縮寫、產品名稱、地名及專業術語。 |
將這些內容寫入聲音規格說明。一份實用的規格說明可能會寫道:「溫暖的女性旁白,清晰的中性美式英語,中等語速,自信但不具推銷感,句子之間有短暫停頓,無誇張氣息感,乾燥錄音室音效,產品名稱發音一致。」
聲音規格說明將成為每份腳本及品質確認流程的參考依據。
使用相同的聲音素材,而非相似的聲音
如果平台提供聲音 ID、已儲存的聲音或克隆聲音,請在整個系列中重複使用完全相同的素材。不要因為另一個聲音的預覽聽起來相近,就選擇全新的聲音。
對於克隆聲音,請保留原始的來源錄音。ElevenLabs 指出,即使使用相同的樣本重新建立克隆,也可能產生略有不同的克隆聲音。這是另一個保留已核准聲音素材、而非日後重新建立的理由。
Media.io 的AI 聲音克隆工作流程可用於建立可重複使用的旁白聲音,適用於敘述、行銷、教育或影片配音。當一致性至關重要時,請將已核准的克隆聲音視為具名的製作素材,並記錄哪些專案有使用它。
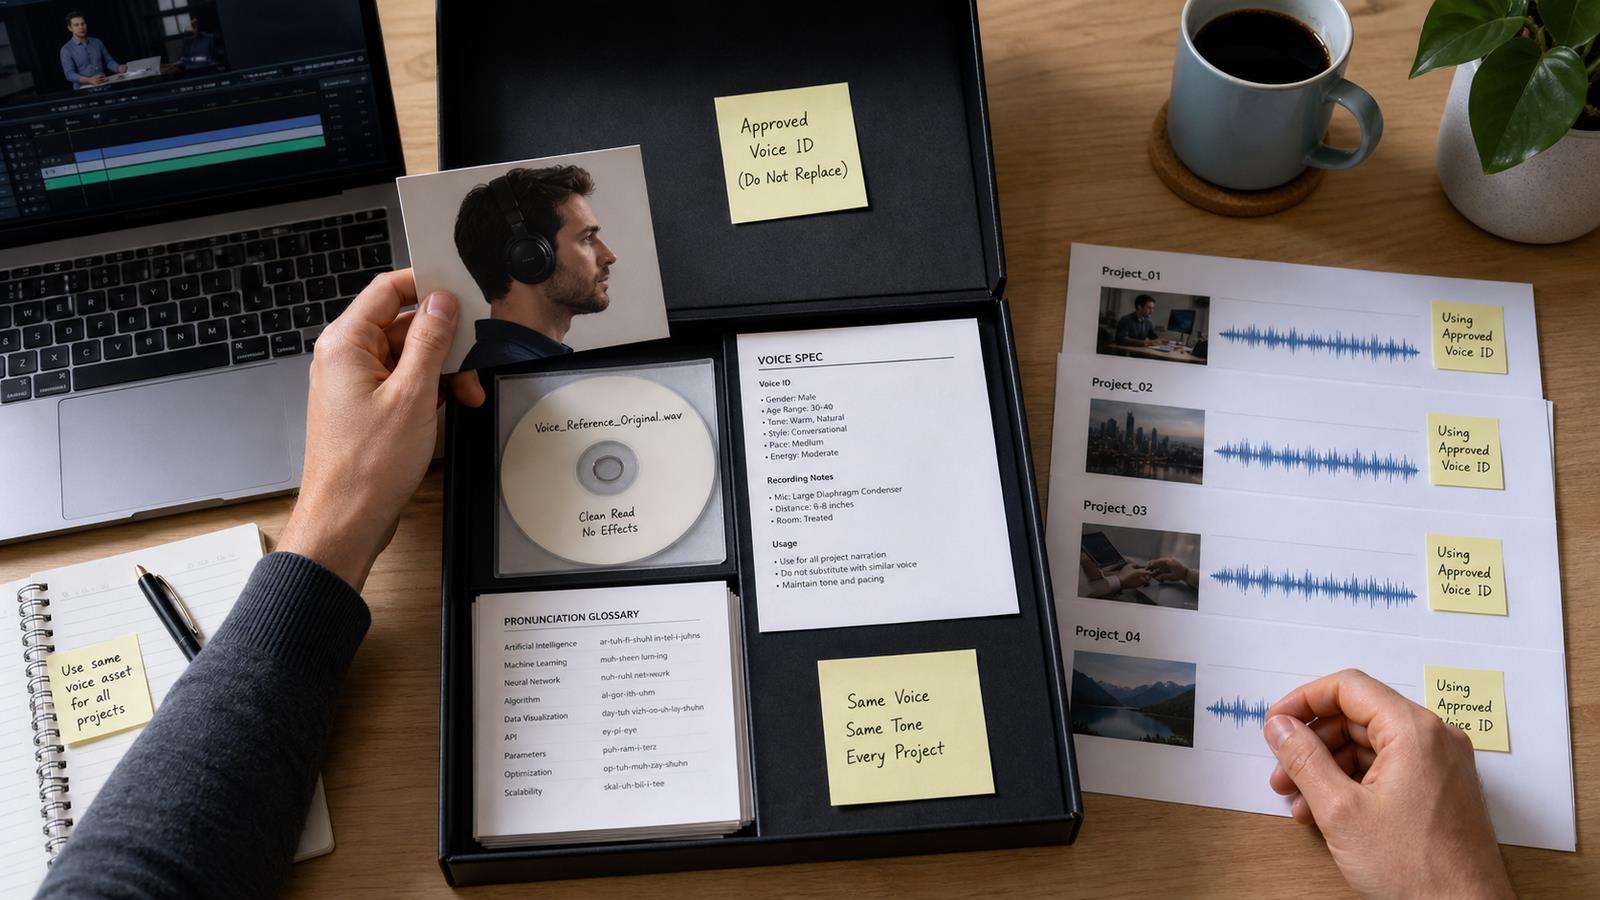
從乾淨且一致的參考音頻開始
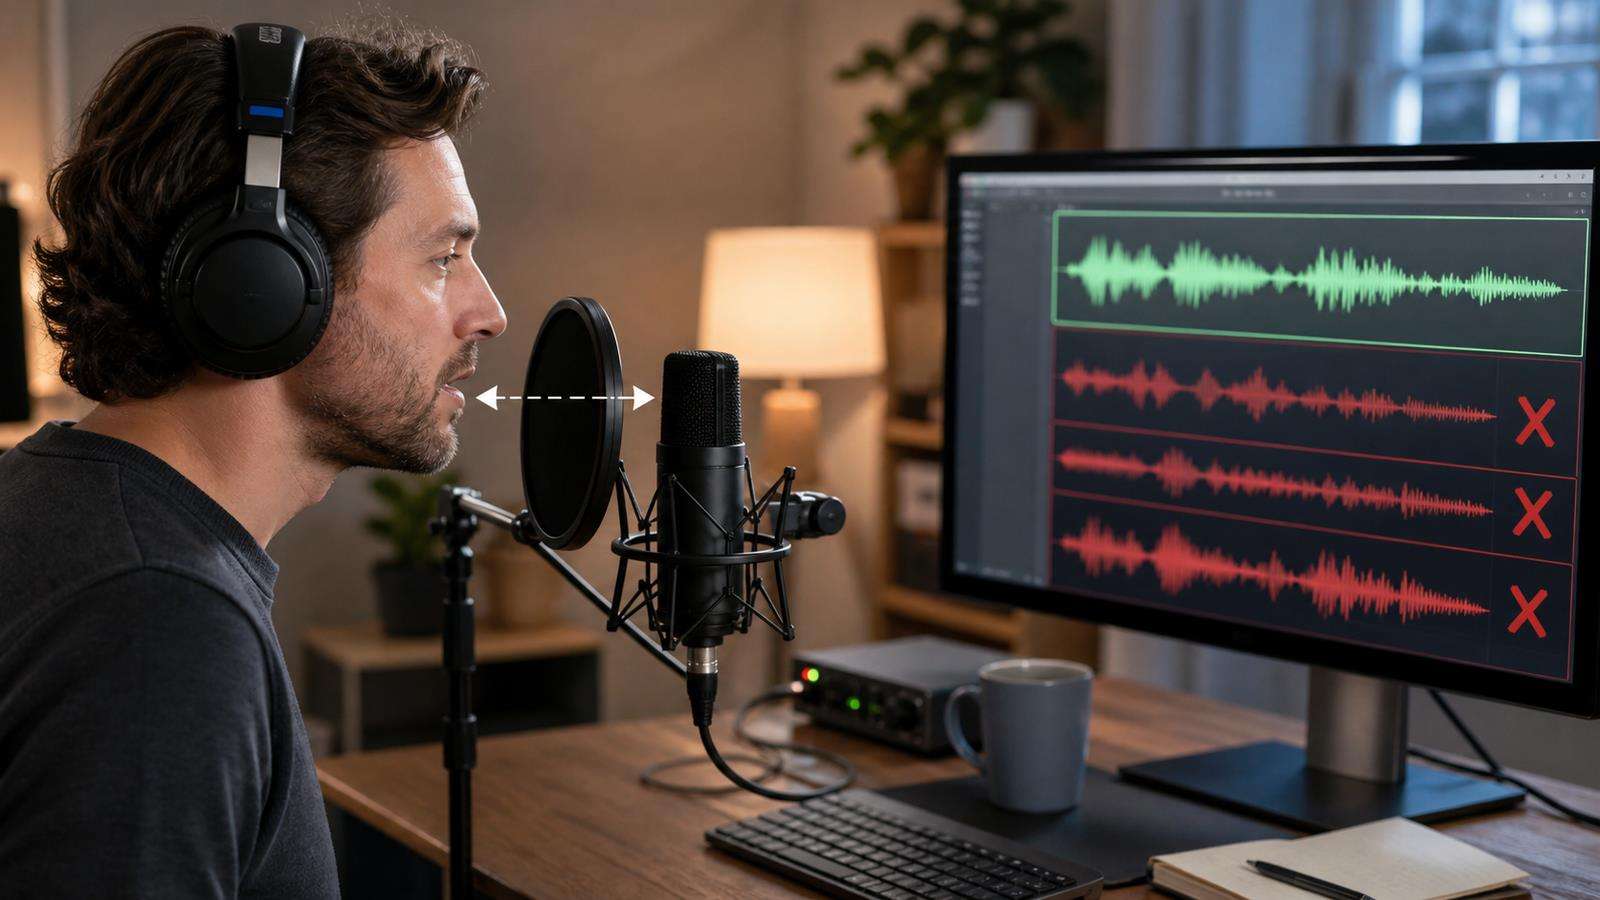
克隆聲音會從其所聽到的內容中學習。背景噪音、空間殘響、更換麥克風、大幅音量變化以及混雜的表演風格,都可能使生成的聲音變得更難預測。
ElevenLabs 建議使用乾淨的單一說話者錄音,並保持一致的音量、語調、音頻品質及表演風格。對於其即時聲音克隆工作流程,建議提供大約一到兩分鐘的優質音頻。專業克隆需要更多的素材,但重要的原則是相同的:品質與一致性比隨機收集的分鐘數更重要。
錄製您真正希望重現的聲音。如果目標是沉穩的企業旁白風格,請勿將低語、喊叫、角色扮演及隨意的電話錄音混入同一組參考素材中。如果您需要多種情緒模式,請有意識地進行管理,而不是讓訓練資料意外地成為混雜的組合。
鎖定整個系列的聲音設定
許多文字轉語音系統提供影響一致性的控制選項。各平台的名稱可能不同,但常見的控制項包括穩定性、相似度、風格、語速、音調、情緒及語言。
記錄已核准片段所使用的設定。如果您在不同影片之間更改了穩定性或風格,即代表您正在刻意改變聲音的表現方式。
ElevenLabs 將穩定性描述為控制輸出與參考的貼近程度,以及每次生成之間隨機性的多寡。它也警告,較強的風格誇張化可能會降低穩定性。這是一個實用的通用原則:為表現力而設計的設定,可能會使系列內容的一致性降低。
在製作時,請建立一個基準預設值。僅在內容確實需要時,才建立個別的具名預設值,例如旁白_中性, 旁白_興奮以及旁白_柔和。不要在每個片段中憑感覺隨意調整滑桿。
Media.io 的文字轉語音功能同樣允許選擇聲音、語言、語速及音調。當一系列影片必須共用同一種旁白風格時,請記錄這些選擇。
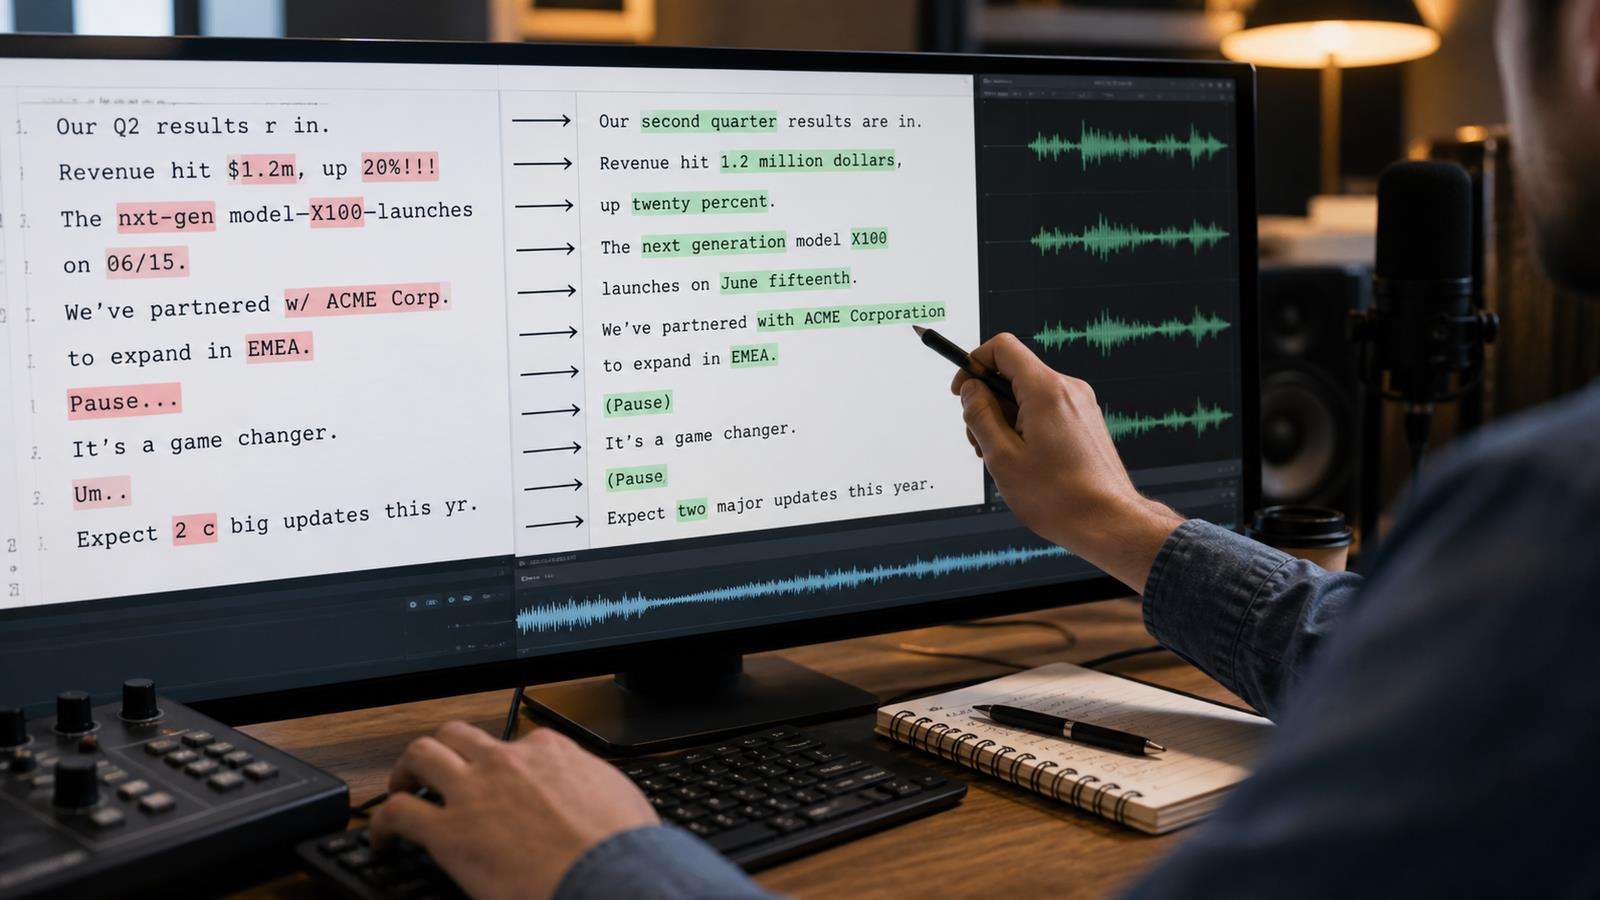
在生成音頻前先標準化腳本
聲音的變化可能來自文字格式,而不僅僅是聲音模型本身。
為以下項目建立腳本規則:
- 句子長度。
- 標點符號風格。
- 數字與日期。
- 縮寫詞。
- 產品名稱。
- 網址。
- 停頓。
- 強調。
- 外來語詞彙。
如果一份腳本寫的是「2026」,另一份寫的是「two thousand and twenty-six」,發音可能會不同。如果一份使用「AI」,另一份使用「A.I.」,節奏可能會改變。如果同一個產品名稱有時使用連字號,有時不使用,模型可能會以不同方式發音。
建立一份發音詞彙表。在系統支援的情況下,以注音方式拼寫出難以發音的術語,或使用您已測試過的穩定文字形式。
以可管理的片段進行生成
較長的生成內容可能在能量、音量、語速或發音方面出現飄移。將腳本拆分為較小的邏輯片段,可以更輕鬆地僅重新生成有問題的那一行,並與參考音頻進行比較。
ElevenLabs 的疑難排解指引明確建議,當較長的生成內容出現音量或品質不均的情況時,應將文字拆分為較小的片段。一個片段可能是一個段落、一個場景,或根據工具和內容不同,約為 10 到 30 秒的旁白。
除非表演顯得過於生硬,否則不要將每個句子都分為獨立的檔案。將屬於同一個思路的句子組合在一起,以便語調能夠自然流暢。在開頭和結尾保留剪輯空間以便調整時序。
以有系統的方式命名檔案,例如:
EP04_S03_VO_01.wav
EP04_S03_VO_02.wav
這樣可以輕鬆地將一行追溯回腳本,並僅重新生成必要的片段。
謹慎控制情緒表達範圍
一致性並不意味著單調的表達。旁白在揭示重要資訊時可以顯得更加興奮,在解釋說明時可以更加平靜,同時仍保持相同的聲音。關鍵在於定義表達的範圍。
為系列內容建立一份簡要的情緒對應表:
- 開場鉤子:充滿活力,短句。
- 說明解釋:中性且清晰。
- 警告提示:語速較慢且更為嚴肅。
- 行動呼籲:溫暖、自信,不要喊叫。
如果某個片段突然使用了在其他地方完全不存在的戲劇化表演風格,聽起來就會像是另一位旁白。請讓情緒風格與基準聲音保持連貫。
當系統提供高度表現力的控制選項時,請生成多個候選版本,並選擇最接近您已核准參考的那一個。不要假設最具戲劇性的版本就是最佳版本。
謹慎地在不同語言間匹配聲音
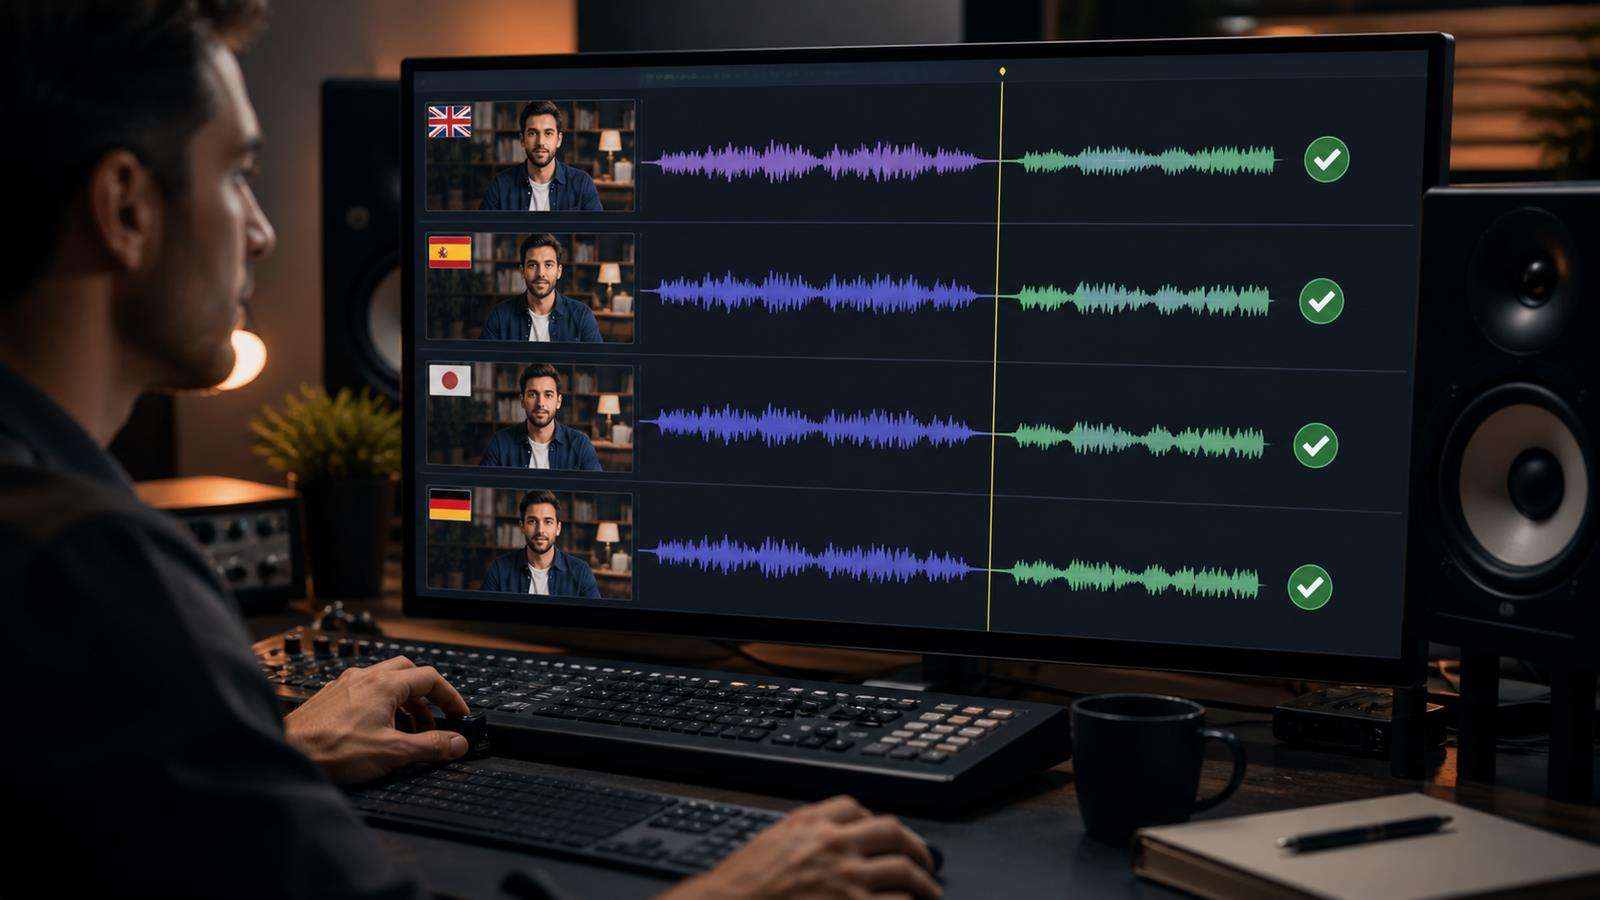
多語言製作引入了另一個層面的考量。克隆的英語聲音在說西班牙語或日語時,可能保留部分識別性,但口音、節奏或發音可能會有所改變。ElevenLabs 指出,克隆聲音在說另一種語言時,可能會帶有來源錄音所使用語言的口音。
決定一致性在不同市場中的意義。您可以優先考慮單一全球聲音識別性,也可以優先考慮以不同目標語言聲音實現在地化的自然表達。兩者都是有效的品牌策略。
對於現有的說話影片,Media.io 的AI 唇形同步功能可將替換的音頻同步至畫面中可見的說話者。對於靜態的主持人圖像,AI 說話虛擬人物可以根據圖像、腳本或音頻生成語音。
對完成的音頻進行音量標準化,而非僅調整生成器設定
兩個片段可以使用相同的 TTS 設定,但在編輯後仍會有不同的感知音量。背景音樂、壓縮、降噪以及影片匯出設定都會影響最終的聲音效果。
為系列內容建立一套音訊後製預設。至少需要檢查:
- 響度。
- 峰值電平。
- 噪音底限。
- 均衡化。
- 壓縮。
- 必要時進行齒音消除。
- 室內環境音或氛圍音。
- 旁白下方的音樂音量。
除非某個片段有特殊原因,否則應套用相同的後製處理流程。若部分來源參考素材含有雜音,請在複製前先進行清理。Media.io 的AI 降噪工具可在不需要的背景聲音出現於來源素材或最終人聲音軌中時,提供清理支援。
在品質確認時使用聲音參考片段
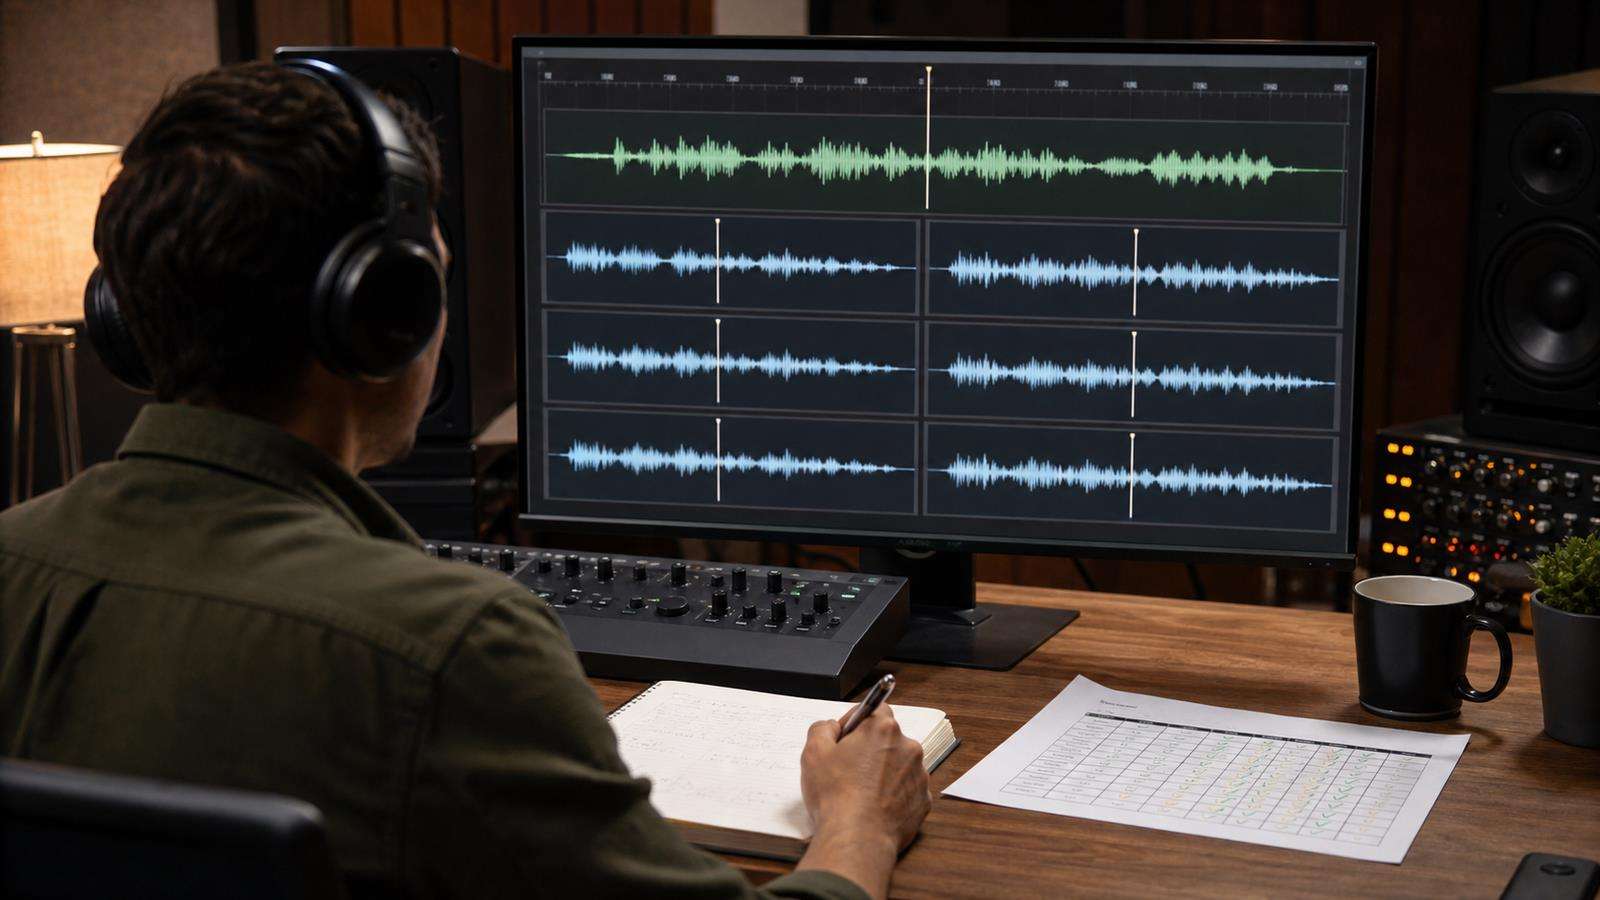
請勿依賴記憶。在每次審聽時,於旁邊放置一段經核准的簡短人聲參考音檔。先播放參考音檔,再播放新片段。
比較:
- 口音與音色。
- 語速。
- 情感能量。
- 發音。
- 氣聲。
- 響度。
- 空間感或處理特性。
並排比較可讓細微的偏差更容易被察覺。對於大型系列,請從每一集擷取一句話,製作成一段連絡試聽片段。連續聆聽這些樣本,可揭示在個別審核時難以察覺的漸進式變化。
建立可重複使用的 Media.io 聲音工作流程
若要擁有穩定的旁白,請先建立或選擇一個聲音,然後保持設定與腳本規範的一致性。以可管理的段落生成配音,對照核准的參考音檔進行審核,再將最終音訊置入影片製作流程中。
若您需要可重複使用的複製聲音,請從Media.io AI 聲音複製開始。若您需要一個可調整語速與音調的現成聲音,請使用文字轉語音。若最終影片中已包含說話的人臉,請在本地化或修正後的音訊獲得核准後,使用唇形同步功能。
AI 聲音一致性檢查清單
在批次發布片段之前,請確認:
- 全程使用相同的核准聲音或複製聲音。
- 參考音訊清晰且一致。
- 聲音設定已儲存,且除非有文件記錄,否則不得變更。
- 腳本格式遵循統一標準。
- 產品名稱及難以發音的術語遵循發音詞彙表。
- 長篇腳本已分割成可管理的段落。
- 情感表達保持在核准範圍內。
- 最終音訊採用相同的響度及處理方式。
- 每個新片段均與參考樣本進行比對。
- 多語言版本遵循有意識的品牌識別對比在地口音策略。
一致的 AI 聲音並非由一個完美的設定所創造,而是一個可重複執行的流程所帶來的結果,該流程控制了輸入、生成、腳本、表現以及後製處理。
控管模型與工作流程的版本
即使腳本和設定保持不變,若底層語音模型發生變更,聲音仍可能產生偏差。製作工具會隨時間持續改進,新模型在處理情感、停頓、發音或聲音複製時的方式可能有所不同。當平台提供相關資訊時,請記錄核准系列所使用的模型或工作流程版本。
在將長期運營的頻道遷移至新模型之前,請使用新舊設定分別生成一段簡短的基準測試腳本。腳本中應包含系列中頻繁出現的產品名稱、數字、情感範圍及句型。在切換整個流程之前,先將兩個版本與核准的參考聲音進行比較。
若新模型更好但聽起來明顯不同,請將此變更視為品牌重塑決策。可選擇從某個計劃的時間點起全面更新整個系列,或在能夠進行清晰過渡之前,為現有內容保留舊的工作流程。靜默式模型更新是旁白聲音即使在無人刻意更改的情況下,仍似乎隨時間演變的原因之一。
關於 AI 聲音一致性的常見問題
為何相同的 AI 聲音在不同片段之間聽起來有所不同?
AI 語音生成並非完全確定性的。參考音訊、文字、標點符號、設定、情感方向、片段長度以及後製處理的差異,都可能改變最終結果。
如何保持複製聲音的一致性?
使用清晰的單一說話者參考音訊,保持語氣與表現的一致性,重複使用相同的複製聲音,儲存生成設定,統一腳本格式,並將新生成的音訊與核准的參考音檔進行比對。
我應該生成一段長篇旁白,還是多個短片段?
建議使用可管理的段落。過長的生成內容可能產生偏差,而逐句生成則可能聽起來不連貫。請將相關句子分組為簡短的邏輯段落,以便於重新生成和編輯。
哪些設定會影響 AI 聲音的一致性?
依平台而異,穩定性、相似度、風格、語速、音調、情感、語言以及模型選擇,都可能影響表現效果。請儲存核准的預設,而非針對每個片段個別調整設定。
如何確保產品名稱在每部影片中的發音保持一致?
建立一份發音詞彙表,並在每份腳本中使用相同的拼寫或音標形式。測試難以發音的名稱一次,並將核准的形式納入製作範本中。
一個 AI 聲音能否在不同語言間保持一致?
聲音識別度在某種程度上通常可以保留,但口音和發音可能會有所變化。請決定品牌是重視統一的全球聲音識別,還是更在地化的區域發音方式,然後一致地執行該策略。